Lorentzian Classification: o guia completo de machine learning
Lorentzian Classification é um indicador de k-vizinhos mais próximos (k-NN) que encontra os candles históricos mais parecidos com o candle atual e prevê a direção a partir de como esses vizinhos se resolveram. Ele mede a semelhança com distância Lorentzian em vez de distância Euclidean, o que comprime leituras extremas para que mercados voláteis distorçam menos a busca. O número de vizinhos, k, define a sensibilidade; versões adaptativas ajustam k às condições de mercado.
Lorentzian Classification é um dos indicadores de machine learning mais comentados no TradingView, e por um bom motivo: em vez das médias móveis e dos limiares de sempre, ele trata o trading como um problema de reconhecimento de padrões. Ele observa as condições atuais do mercado, pesquisa no histórico as situações passadas mais parecidas e classifica o provável próximo movimento com base no que aconteceu naquelas vezes — usando uma medida de distância incomum, a distância Lorentzian, que lida com mercados voláteis de forma mais elegante do que a geometria comum.
Este guia explica o que Lorentzian Classification realmente é, como a ideia de k-vizinhos mais próximos e a distância Lorentzian funcionam em linguagem simples, o que significam os recursos e as configurações e como usá-lo com bom senso sem cair nas armadilhas comuns de "indicador de IA". Ele também percorre um exemplo ao vivo usando a própria implementação Adaptive Lorentzian da Quantum Algo, para que você veja o conceito em um gráfico real.
Que tipo de modelo é Lorentzian Classification?
No fundo, Lorentzian Classification é um classificador de k-vizinhos mais próximos (k-NN) aplicado ao preço. k-NN é um dos métodos de machine learning mais antigos e intuitivos: para classificar um novo exemplo, você encontra os k exemplos passados mais parecidos e deixa que eles votem. Aplicado ao trading, cada "exemplo" é um retrato das condições de mercado em um candle — descrito por alguns valores de indicadores — e o rótulo é o que o preço fez em seguida. O candle atual é classificado encontrando os candles históricos mais parecidos e verificando se eles foram seguidos principalmente por movimentos de alta ou de baixa.
O que torna este indicador específico diferente é a escolha da distância. Para decidir quais candles passados são "mais parecidos", você precisa de uma forma de medir a lacuna entre dois retratos do mercado. A maioria dos métodos usa distância Euclidean — a geometria comum de linha reta. Lorentzian Classification, por sua vez, usa distância Lorentzian, uma medida emprestada da matemática do espaço-tempo, que comprime o efeito de grandes diferenças. Na prática, isso significa que leituras extremas e voláteis distorcem menos a busca por semelhança, então os vizinhos encontrados tendem a ser mais genuinamente comparáveis em mercados turbulentos.
Como o k-NN classifica o candle atual?
A mecânica fica mais fácil de acompanhar como uma sequência. Cada candle histórico é armazenado como um ponto em um "espaço de recursos", cujos eixos são as leituras dos indicadores naquele candle. Quando um novo candle se forma, o modelo o coloca nesse mesmo espaço e mede a distância Lorentzian até cada ponto armazenado. Ele mantém os k mais próximos — os vizinhos mais próximos — e observa como o preço se resolveu depois de cada um deles. Se a maioria dessas situações passadas semelhantes foi seguida por um movimento de alta, o candle atual é classificado como de alta; se a maioria levou a movimentos de baixa, como de baixa.
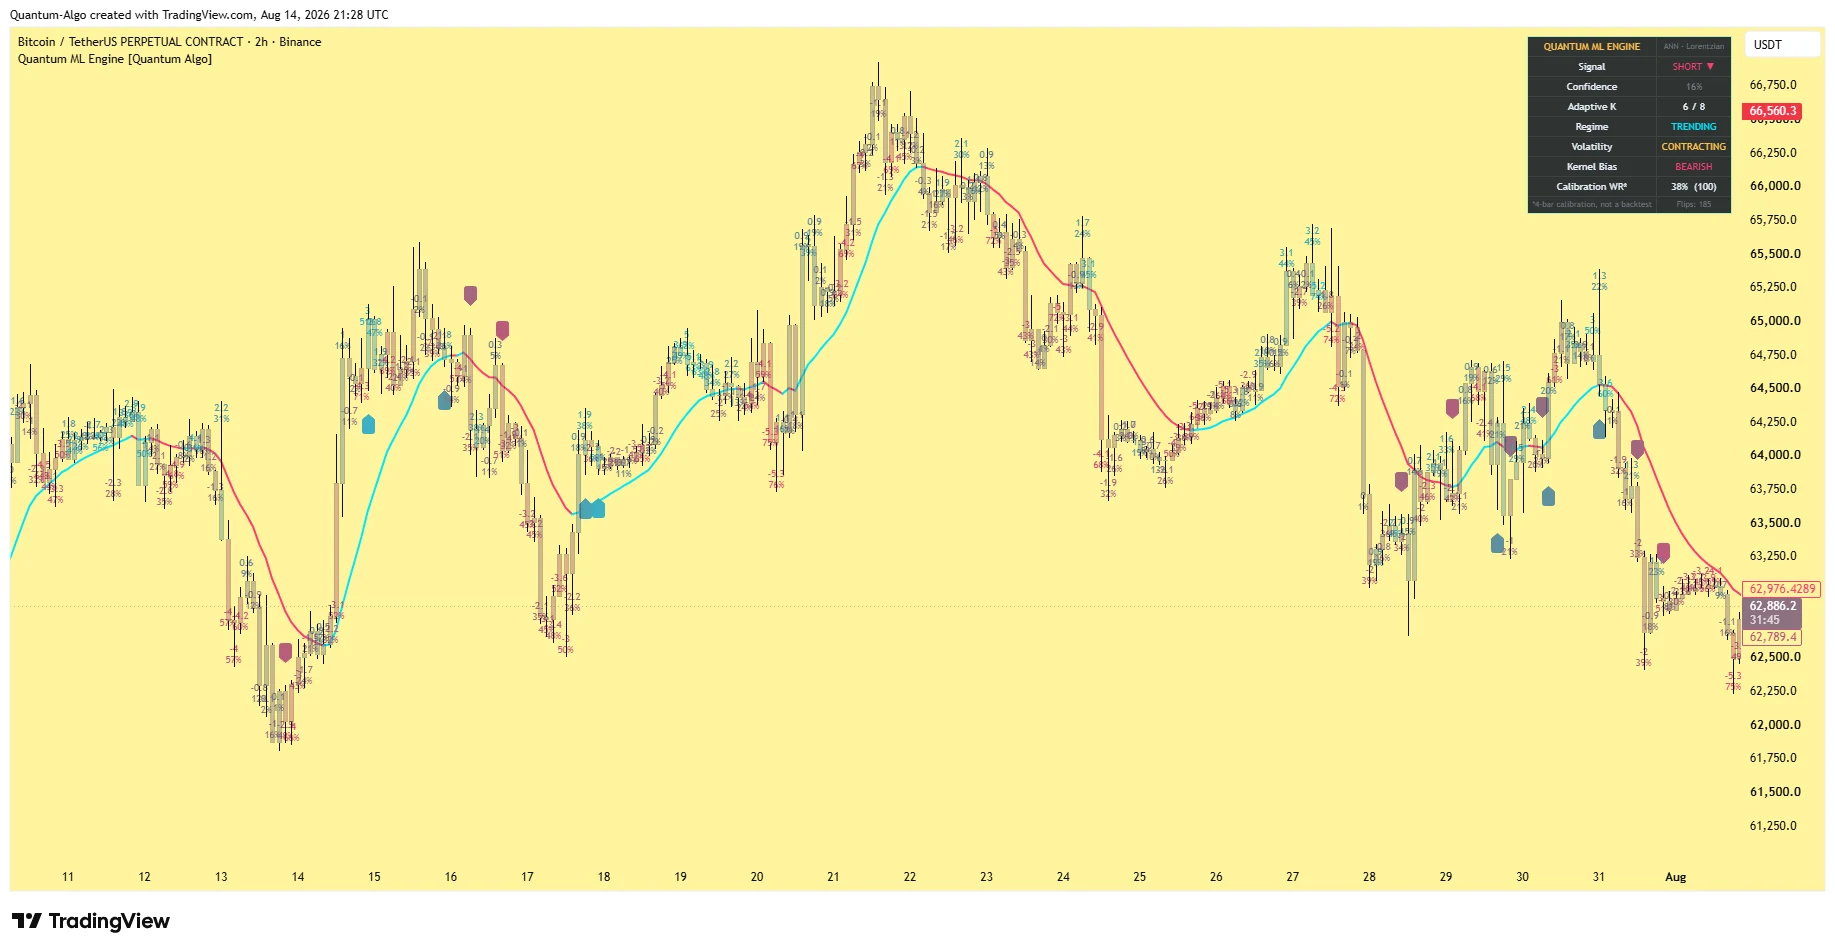
O número k importa. Um k pequeno torna o modelo sensível e reativo, mas ruidoso; um k grande suaviza a votação, mas pode borrar sinais genuínos. É exatamente por isso que implementações adaptativas, como o AI-clustered Supertrend, ajustam k às condições em vez de deixá-lo fixo — o Quantum ML Engine no gráfico acima mostra um "Adaptive K" de 6/8, o que significa que ele está usando atualmente seis de oito vizinhos possíveis com base no estado do mercado. A classificação que você vê é o voto agregado desses análogos históricos.
Classificando o candle atual pelos vizinhos
Encontre os k candles históricos mais parecidos e depois vote na direção a partir de como eles se resolveram.
Por que medir semelhança com distância Lorentzian, não Euclidean?
A métrica de distância é o coração do que torna este indicador diferente, então vale a pena entendê-la intuitivamente. Imagine dois retratos do mercado que são parecidos na maioria dos aspectos, mas diferem bastante em uma leitura volátil — digamos, um pico de momentum. A distância Euclidean eleva diferenças ao quadrado, então essa única lacuna grande domina o cálculo e empurra os dois retratos para longe um do outro, mesmo que eles sejam parecidos em todos os outros pontos. O modelo então deixaria passar um candle histórico genuinamente comparável.
Distância Euclidean vs Lorentzian
O quadrado da Euclidean deixa uma lacuna grande dominar; a Lorentzian cresce apenas logaritmicamente, mantendo a robustez.
A distância Lorentzian cresce apenas logaritmicamente com grandes diferenças, então uma única leitura extrema não infla a medida de semelhança. Candles semelhantes, mas voláteis, permanecem próximos no espaço de recursos, complementando ferramentas como o Gaussian Channel, o que significa que a busca por vizinhos mais próximos encontra situações mais verdadeiramente análogas quando os mercados estão turbulentos — exatamente quando análogos confiáveis são mais valiosos. Essa robustez à volatilidade e a outliers é todo o motivo para a escolha da métrica Lorentzian, e é por isso que o indicador muitas vezes se comporta de forma mais sensata em price action caótico do que um classificador de geometria simples se comportaria.
Distância Euclidean vs Lorentzian em resumo
| Propriedade | Distância Euclidean | Distância Lorentzian |
|---|---|---|
| Termo por recurso | Diferença ao quadrado | Log de 1 mais a diferença absoluta |
| Crescimento com grandes lacunas | Quadrático | Logarítmico |
| Uma leitura extrema | Domina a distância total | Comprimida, não consegue dominar |
| Candles semelhantes em mercados voláteis | Empurrados para longe | Mantidos próximos |
| Busca por vizinhos em mercados turbulentos | Encontra menos análogos verdadeiros | Encontra mais candles análogos |
◆Ambas as métricas trabalham sobre os mesmos recursos normalizados; só muda a ponderação das diferenças.
O que o modelo realmente enxerga em cada candle?
Um classificador k-NN só é tão bom quanto os recursos que descrevem cada candle. Lorentzian Classification normalmente descreve as condições de mercado com um pequeno conjunto de leituras técnicas normalizadas — geralmente osciladores de momentum e tendência, como RSI, uma medida no estilo Wave Trend ou CCI, e ADX para força da tendência. Cada candle vira uma lista curta desses valores, e essa lista são suas coordenadas no espaço de recursos onde a semelhança é medida.
A escolha e o número de recursos moldam tudo que vem depois. Poucos demais, e o modelo não consegue distinguir situações significativamente diferentes; muitos demais, e a "maldição da dimensionalidade" faz todo candle parecer mais ou menos equidistante, enfraquecendo a busca por vizinhos. Boas implementações mantêm o conjunto de recursos compacto, normalizado e complementar — cada recurso capturando um aspecto diferente do mercado — para que "mais próximo" no espaço de recursos realmente signifique "mais parecido" em termos de mercado.
Recursos de momentum
Leituras como RSI ou um oscilador Wave Trend capturam se o mercado está esticado ou acumulando energia, de forma muito parecida com uma leitura de squeeze momentum — uma parte central do que torna duas situações comparáveis.
Recursos de tendência
Uma medida de força da tendência, como ADX, diz ao modelo se um retrato veio de um ambiente em tendência ou em lateralização, o que afeta fortemente o que acontece em seguida.
Normalização
Os recursos são escalonados para faixas comparáveis, de modo que nenhum deles domine a distância apenas por causa de suas unidades — um pré-requisito para qualquer modelo baseado em distância.
Conjunto compacto
Um punhado de recursos complementares supera uma pilha grande de recursos correlacionados, mantendo a busca por vizinhos significativa em vez de diluída.
Lendo o painel do Quantum ML Engine
O gráfico acima é a implementação Adaptive Lorentzian da Quantum Algo, e seu painel torna visível o estado interno do modelo — uma boa forma de aprender o que o indicador está fazendo. Cada linha é uma saída ao vivo do classificador e da lógica que o apoia, então você consegue ver não apenas um sinal, mas o contexto por trás dele.
O que cada linha do painel mostra
O sinal é o voto; as outras linhas dizem o quanto você deve confiar nele e qual regime o produziu.
O hábito mais importante é ler o sinal em contexto. Um sinal short com baixa confiança em um regime de volatilidade em contração e tendência é uma proposta muito diferente de um sinal de alta confiança enquanto a volatilidade se expande. Vale notar que o Quantum ML Engine rotula seu número de taxa de acerto como uma "calibração, não um backtest" curta — um lembrete honesto de que uma taxa de acerto recente em uma janela pequena é uma checagem de saúde da calibração atual do modelo, não uma promessa de desempenho futuro. Tratar cada leitura como contexto probabilístico, e não como garantia, é a mentalidade correta para qualquer indicador de ML.
Em que Lorentzian Classification é bom, e onde ele falha?
Quando bem usado, Lorentzian Classification tem pontos fortes reais. Ele se adapta aos dados de fato, em vez de presumir um modelo fixo do mercado; sua métrica Lorentzian o torna robusto exatamente nas condições voláteis em que ferramentas mais simples quebram, ao contrário de uma ferramenta de média móvel; e uma boa implementação oferece uma leitura nuançada e probabilística, completa com confiança e contexto de regime. É uma lente genuinamente diferente para observar o mercado em comparação com o conjunto habitual de médias móveis.
Mas ele não é mágica, e ser honesto sobre seus limites é o que separa bons usuários dos decepcionados. Ele ainda é reconhecimento de padrões em dados passados: se o futuro deixa de se parecer com o passado — uma mudança real de regime sem análogo histórico — seus vizinhos se tornam enganosos. Ele não sabe por que algo acontece, apenas o que tendia a vir depois de leituras semelhantes. Ele pode sofrer curve-fit por excesso de ajuste — por isso um backtesting honesto importa — e, como qualquer indicador, pode produzir sequências de perdas. Ele é um sinal probabilístico de alta qualidade para combinar com estrutura, contexto e gestão de risco rígida — não um oráculo independente.
Você deve operar sinais Lorentzian sozinhos?
A forma produtiva de usar Lorentzian Classification é como um filtro direcional de alta qualidade e um motor de contexto, não como um gatilho cego de compra/venda. Deixe o classificador dizer qual lado tem a vantagem histórica agora e o nível de confiança dele, depois exija sua própria confirmação antes de agir — um market-structure shift na mesma direção, um nível-chave ou um sinal de entrada separado. A classificação define o viés; sua estrutura e seu plano de risco definem o trade.
Transformando o classificador em um sinal filtrado
Filtre a classificação bruta por confiança e regime, depois exija sua própria confirmação.
Ele também combina naturalmente com a mesma disciplina que qualquer indicador exige: dê mais peso a sinais de maior confiança, respeite o contexto de regime e volatilidade fornecido pelo painel e dimensione cada trade com gestão de risco rigorosa para que uma única classificação errada não machuque. Como o Quantum ML Engine expõe confiança, regime e volatilidade explicitamente, você pode criar regras simples — por exemplo, aceitar apenas sinais acima de um limite de confiança em um regime de tendência — que transformam um classificador bruto em um sistema disciplinado e filtrado.
• Motor Adaptive Lorentzian — Adaptive K, detecção de regime e volatilidade com pontuação de confiança
• Calibração honesta — Uma leitura de calibração transparente, explicitamente não apresentada como backtest
• Desempenho responsável — Um histórico verificado público por trás de cada sinal
◆ Experimente o motor Adaptive Lorentzian
O Adaptive Lorentzian Classification da Quantum Algo — o Quantum ML Engine mostrado acima — leva Adaptive K, detecção de regime e volatilidade, pontuação de confiança e calibração honesta aos seus gráficos, em camadas com o mesmo contexto de Smart Money Concepts do restante da suíte, tudo respaldado por um histórico verificado público.
Veja o script no TradingView → Verifique o históricoPerguntas frequentes
Lorentzian Classification é um indicador de machine learning que trata o trading como um problema de reconhecimento de padrões. Ele usa um modelo de k-vizinhos mais próximos para encontrar os candles históricos mais parecidos com as condições atuais e classifica o provável próximo movimento com base em como aquelas situações passadas semelhantes se resolveram. Sua característica definidora é o uso da distância Lorentzian — em vez da distância Euclidean comum — para medir semelhança, o que o torna mais robusto em mercados voláteis.
Cada candle histórico é armazenado como um ponto em um espaço de recursos, cujos eixos são leituras de indicadores como RSI, um oscilador Wave Trend e ADX. Quando um novo candle se forma, o modelo mede a distância Lorentzian dele até cada candle armazenado, mantém os k vizinhos mais próximos e observa como o preço se resolveu depois de cada um. Se a maioria dos candles passados semelhantes foi seguida por movimentos de alta, o candle atual é classificado como de alta; se a maioria levou a movimentos de baixa, como de baixa. O sinal é o voto agregado desses análogos históricos.
A distância Lorentzian é uma forma de medir quão diferentes são dois retratos do mercado, emprestada da matemática do espaço-tempo. Diferente da distância Euclidean, que eleva diferenças ao quadrado para que uma única lacuna grande domine, a distância Lorentzian cresce apenas logaritmicamente com grandes diferenças. Isso significa que uma leitura extrema e volátil não infla a medida de semelhança, então candles semelhantes, mas voláteis, permanecem próximos e o modelo encontra situações históricas genuinamente comparáveis mesmo em mercados turbulentos — exatamente quando análogos confiáveis mais importam.
Sim, legitimamente — k-vizinhos mais próximos é um dos algoritmos de machine learning mais antigos e estabelecidos. Ele é "machine learning" no sentido de que classifica novos dados aprendendo com exemplos históricos rotulados, em vez de seguir regras codificadas manualmente. No entanto, ele não é uma rede neural nem um grande modelo que "entende" mercados; é um classificador baseado em semelhança. Essa distinção importa: ele é poderoso e adaptativo, mas é reconhecimento de padrões no histórico, não raciocínio sobre causa.
K é o número de vizinhos mais próximos que o modelo usa para votar na classificação. Um K pequeno torna o indicador reativo, mas ruidoso; um K grande suaviza a votação, mas pode borrar sinais reais. "Adaptive K" significa que a implementação ajusta esse número com base nas condições de mercado, em vez de fixá-lo — por exemplo, o Quantum ML Engine mostra um Adaptive K de 6/8, o que significa que ele está usando atualmente seis de oito vizinhos possíveis diante do regime e da volatilidade detectados.
Ele normalmente descreve cada candle com um pequeno conjunto de leituras técnicas normalizadas — geralmente um oscilador de momentum como RSI, uma medida no estilo Wave Trend ou CCI e uma medida de força da tendência como ADX. Elas se tornam as coordenadas do candle no espaço de recursos onde a semelhança é medida. Boas implementações mantêm o conjunto de recursos compacto, normalizado e complementar, porque recursos de menos não conseguem distinguir situações, e recursos demais acionam a "maldição da dimensionalidade", que faz todo candle parecer equidistante.
Uma versão bem construída que classifica em candles fechados não repinta — depois que um candle fecha, seus recursos e sua classificação ficam fixos. No entanto, as implementações variam, e algumas exibem atualizações em tempo real no candle em formação que se estabilizam quando ele fecha. Se você depende dos sinais, verifique o script específico observando-o se formar ao vivo e confirmando que as classificações históricas não mudam ao recarregar. Como em qualquer indicador, confie apenas no que se sustenta em testes de tempo real com candle fechado.
A taxa de acerto de calibração é uma hit-rate recente que o modelo informa em uma janela curta como checagem de saúde da sua calibração atual. O ponto importante é que o Quantum ML Engine a rotula explicitamente como calibração "não um backtest" — um lembrete honesto de que uma taxa de acerto em uma amostra pequena e recente é um medidor de quão bem o modelo está ajustado no momento, não uma projeção de desempenho futuro. Ela deve ser lida como contexto probabilístico junto com o sinal, a confiança, o regime e a volatilidade, nunca como garantia.
Ele é reconhecimento de padrões em dados passados, então, se o futuro deixa de se parecer com o passado — uma mudança real de regime sem análogo histórico — seus vizinhos mais próximos se tornam enganosos e sua vantagem enfraquece. Ele não sabe por que algo acontece, apenas o que tendia a vir depois de leituras semelhantes. Ele pode sofrer curve-fit por excesso de ajuste e, como qualquer indicador, produz sequências de perdas. O ideal é tratá-lo como um sinal probabilístico de alta qualidade para combinar com estrutura de mercado, contexto e gestão de risco rigorosa — não como um oráculo independente.
Use-o como filtro direcional e motor de contexto, em vez de gatilho cego. Deixe o classificador dizer qual lado tem a vantagem histórica e qual é sua confiança, depois exija sua própria confirmação — um market-structure shift na mesma direção, um nível-chave ou um sinal de entrada separado — antes de agir. Como implementações como o Quantum ML Engine expõem confiança, regime e volatilidade explicitamente, você pode criar regras simples, como aceitar apenas sinais acima de um limite de confiança em um regime de tendência, transformando um classificador bruto em um sistema disciplinado.
Ele é diferente, não estritamente melhor. Médias móveis são simples, transparentes e atrasam por definição; Lorentzian Classification é adaptativo, robusto à volatilidade e oferece contexto probabilístico com confiança e regime, mas é mais complexo e depende de o histórico se parecer com o presente. Muitos traders os consideram complementares — uma ferramenta de média móvel ou canal para um contexto limpo de tendência e um classificador Lorentzian para uma leitura direcional mais nuançada. Nenhum dos dois substitui estrutura e gestão de risco.
A Quantum Algo publica um Adaptive Lorentzian Classification — o Quantum ML Engine mostrado neste guia — no TradingView. Ele adiciona Adaptive K, detecção de regime e volatilidade, pontuação de confiança e calibração honesta ao método Lorentzian k-NN central, e aplica em camadas o mesmo contexto de Smart Money Concepts do restante da suíte. Você pode ver o script diretamente no TradingView, e seus sinais são respaldados pelo histórico verificado público da Quantum Algo.
Referências e guias relacionados
Mais neste tópico
- Indicadores de trading de machine learning (Lorentzian): guia completo
- SuperTrend AI (Clustering): o guia completo
- AI Trading Journal: como usar um para realmente melhorar
- Guia do indicador Gaussian Channel
- Melhores indicadores do TradingView
- Indicadores non-repaint: o guia completo para sinais confiáveis
- Guia do indicador RSI
- Indicador Squeeze Momentum (TTM Squeeze): guia completo
- Melhor indicador de compra/venda: como escolher um que realmente funciona
- Backtesting de estratégia de trading — guia completo de validação
- Smart Money Concepts (SMC): guia definitivo de trading
- Estratégia de trend trading: o guia completo
- Melhores bots de trading — ranking: automatize seu trading
- Guia do indicador Supertrend
Leitura essencial
- Indicadores de trading de machine learning (Lorentzian): guia completo
- Melhores indicadores do TradingView
- Gestão de risco no trading: o guia completo de sobrevivência
- Todos os guias premium
- Track Record público
- Quantum Algo no TradingView