Lorentzian Classification : le guide complet machine learning
Lorentzian Classification est un indicateur k-nearest-neighbors qui trouve les bougies historiques les plus similaires à la bougie actuelle et prédit la direction à partir de la façon dont ces voisines se sont résolues. Il mesure la similarité avec la distance lorentzienne au lieu de la distance euclidienne, ce qui compresse les lectures extrêmes afin que les marchés volatils déforment moins la recherche. Le nombre de voisines, k, règle la sensibilité ; les versions adaptatives ajustent k aux conditions de marché.
Lorentzian Classification est l'un des indicateurs machine learning les plus commentés sur TradingView, et ce n'est pas un hasard : au lieu des moyennes mobiles et seuils habituels, il traite le trading comme un problème de reconnaissance de motifs. Il observe les conditions de marché actuelles, cherche dans l'historique les situations passées les plus similaires, puis classe le prochain mouvement probable selon ce qui s'est produit dans ces cas — avec une mesure de distance inhabituelle, la distance lorentzienne, qui gère les marchés volatils avec plus de souplesse que la géométrie ordinaire.
Ce guide explique ce qu'est réellement Lorentzian Classification, comment fonctionnent en langage simple l'idée des k-nearest-neighbours et la distance lorentzienne, ce que signifient les features et les réglages, et comment l'utiliser avec bon sens sans tomber dans les pièges courants des « indicateurs IA ». Il parcourt aussi un exemple en direct avec la propre implémentation Adaptive Lorentzian de Quantum Algo, afin que vous puissiez voir le concept sur un graphique réel.
Quel type de modèle est Lorentzian Classification ?
Au fond, Lorentzian Classification est un classificateur k-nearest-neighbours (k-NN) appliqué au prix. k-NN fait partie des méthodes de machine learning les plus anciennes et les plus intuitives : pour classer un nouvel exemple, vous trouvez les k exemples passés les plus similaires et vous les laissez voter. Appliqué au trading, chaque « exemple » est un instantané des conditions de marché sur une bougie — décrit par une poignée de valeurs d'indicateurs — et l'étiquette est ce que le prix a fait ensuite. La bougie actuelle est classée en trouvant les bougies historiques les plus similaires, puis en observant si elles ont majoritairement été suivies de mouvements haussiers ou baissiers.
Ce qui rend cet indicateur particulier, c'est le choix de la distance. Pour décider quelles bougies passées sont « les plus similaires », il faut une façon de mesurer l'écart entre deux instantanés de marché. La plupart des méthodes utilisent la distance euclidienne — la géométrie ordinaire en ligne droite. Lorentzian Classification utilise plutôt la distance lorentzienne, une mesure empruntée aux mathématiques de l'espace-temps, qui compresse l'effet des grandes différences. En pratique, cela signifie que les lectures extrêmes et volatiles déforment moins la recherche de similarité, de sorte que les voisines trouvées ont tendance à être plus réellement comparables dans les marchés agités.
Comment k-nearest-neighbours classe-t-il la bougie actuelle ?
La mécanique est plus facile à suivre comme une séquence. Chaque bougie historique est stockée comme un point dans un « espace des features » dont les axes sont les lectures d'indicateurs sur cette bougie. Lorsqu'une nouvelle bougie se forme, le modèle la place dans ce même espace et mesure la distance lorentzienne jusqu'à chaque point stocké. Il conserve les k plus proches — les nearest neighbours — puis regarde comment le prix s'est résolu après chacune d'elles. Si la plupart de ces situations passées similaires ont été suivies d'un mouvement haussier, la bougie actuelle est classée haussière ; si la plupart ont mené à des mouvements baissiers, elle est classée baissière.
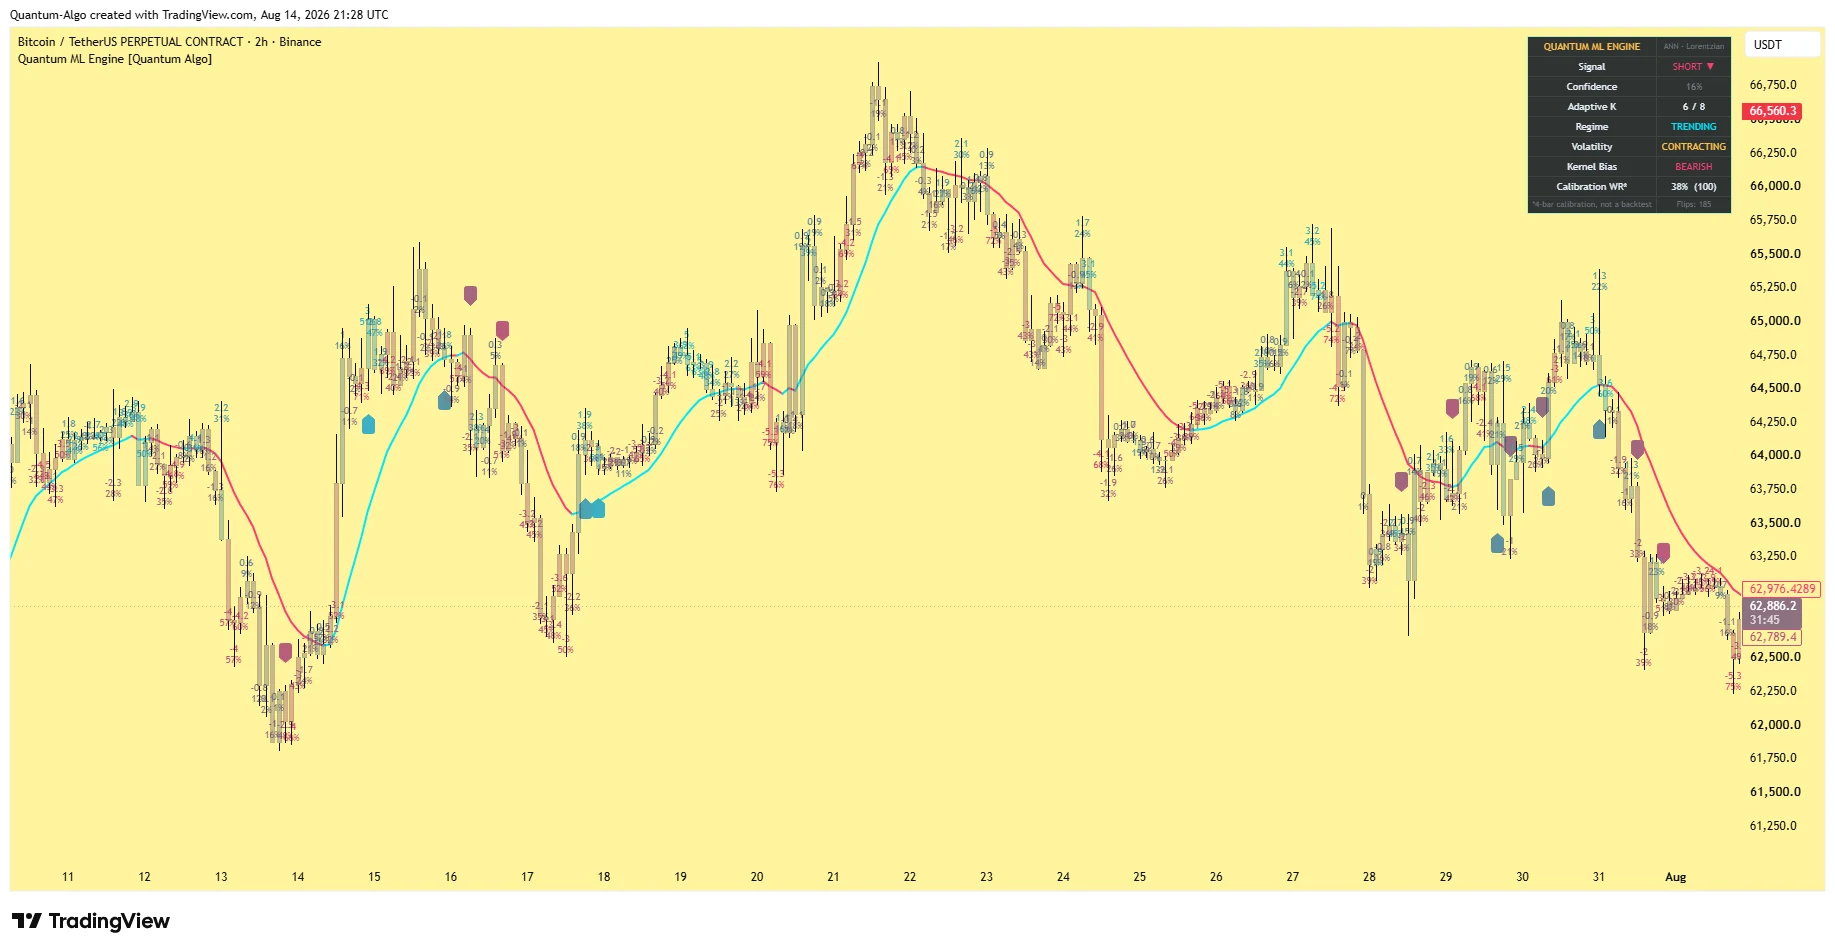
Le nombre k compte. Un petit k rend le modèle sensible et réactif mais bruyant ; un grand k lisse le vote mais peut flouter de vrais signaux. C'est exactement pourquoi les implémentations adaptatives, comme AI-clustered Supertrend, ajustent k aux conditions au lieu de le fixer — le Quantum ML Engine dans le graphique ci-dessus affiche un « Adaptive K » de 6/8, ce qui signifie qu'il utilise actuellement six voisines sur huit possibles selon l'état du marché. La classification que vous voyez est le vote agrégé de ces analogues historiques.
Classer la bougie actuelle par ses voisines
Trouvez les k bougies historiques les plus similaires, puis votez sur la direction selon la façon dont elles se sont résolues.
Pourquoi mesurer la similarité avec la distance lorentzienne, et non euclidienne ?
La métrique de distance est au cœur de ce qui rend cet indicateur différent ; il vaut donc la peine de l'appréhender intuitivement. Imaginez deux instantanés de marché similaires sur presque tous les points, mais très différents sur une lecture volatile — par exemple un pic de momentum. La distance euclidienne élève les différences au carré, si bien que ce seul grand écart domine le calcul et éloigne fortement les deux instantanés, alors qu'ils se ressemblent par ailleurs. Le modèle passerait alors à côté d'une bougie historique réellement comparable.
Distance euclidienne vs distance lorentzienne
Le carré euclidien laisse un gros écart dominer ; la lorentzienne ne croît que logarithmiquement et reste robuste.
La distance lorentzienne ne croît que logarithmiquement avec les grandes différences, de sorte qu'une seule lecture extrême ne fait pas exploser la mesure de similarité. Les bougies similaires mais volatiles restent proches dans l'espace des features, en complément d'outils comme le Gaussian Channel, ce qui permet à la recherche de nearest neighbours de trouver des situations plus vraiment analogues quand les marchés sont turbulents — précisément lorsque des analogues fiables ont le plus de valeur. Cette robustesse à la volatilité et aux valeurs aberrantes est toute la raison du choix de la métrique lorentzienne, et explique pourquoi l'indicateur se comporte souvent plus intelligemment dans une action du prix chaotique qu'un classificateur de géométrie simple.
Distance euclidienne vs lorentzienne en un coup d'œil
| Propriété | Distance euclidienne | Distance lorentzienne |
|---|---|---|
| Terme par feature | Différence au carré | Log de 1 plus la différence absolue |
| Croissance avec de grands écarts | Quadratique | Logarithmique |
| Une lecture extrême | Domine la distance totale | Compressée, ne peut pas dominer |
| Bougies similaires dans les marchés volatils | Repoussées très loin | Gardées proches |
| Recherche de voisines dans les marchés turbulents | Trouve moins de vrais analogues | Trouve davantage de bougies analogues |
◆Les deux métriques travaillent sur les mêmes features normalisées ; seule la pondération des différences change.
Que voit réellement le modèle sur chaque bougie ?
Un classificateur k-NN ne vaut que par les features qui décrivent chaque bougie. Lorentzian Classification décrit généralement les conditions de marché avec un petit ensemble de lectures techniques normalisées — couramment des oscillateurs de momentum et de tendance comme le RSI, une mesure de type Wave Trend ou CCI, et l'ADX pour la force de tendance. Chaque bougie devient une courte liste de ces valeurs, et cette liste constitue ses coordonnées dans l'espace des features où la similarité est mesurée.
Le choix et le nombre de features façonnent tout ce qui vient ensuite. Trop peu, et le modèle ne peut pas distinguer des situations réellement différentes ; trop, et la « malédiction de la dimensionnalité » fait que chaque bougie semble à peu près à la même distance, affaiblissant la recherche de voisines. Les bonnes implémentations gardent un ensemble de features compact, normalisé et complémentaire — chaque feature capturant un aspect différent du marché — afin que « plus proche » dans l'espace des features signifie vraiment « plus similaire » en termes de marché.
Features de momentum
Des lectures comme le RSI ou un oscillateur Wave Trend capturent si le marché est étiré ou accumule de l'énergie, un peu comme une lecture de squeeze momentum — une partie centrale de ce qui rend deux situations comparables.
Features de tendance
Une mesure de force de tendance comme l'ADX indique au modèle si un instantané vient d'un environnement en tendance ou en range, ce qui influence fortement la suite.
Normalisation
Les features sont mises à l'échelle sur des plages comparables afin qu'aucune ne domine la distance simplement à cause de ses unités — un prérequis pour tout modèle fondé sur la distance.
Ensemble compact
Une poignée de features complémentaires vaut mieux qu'une grosse pile de features corrélées, car elle garde la recherche de voisines pertinente au lieu de la diluer.
Lire le tableau de bord du Quantum ML Engine
Le graphique ci-dessus montre l'implémentation Adaptive Lorentzian de Quantum Algo, et son tableau de bord rend visible l'état interne du modèle — une bonne façon d'apprendre ce que fait l'indicateur. Chaque ligne est une sortie en direct du classificateur et de sa logique de soutien, ce qui vous permet de voir non seulement un signal, mais aussi le contexte qui le sous-tend.
Ce que vous dit chaque ligne du tableau de bord
Le signal est le vote ; les autres lignes vous disent dans quelle mesure lui faire confiance et quel régime l'a produit.
L'habitude la plus importante consiste à lire le signal dans son contexte. Un signal short avec une faible confiance dans un régime de tendance à volatilité contractée est une proposition très différente d'un signal de forte confiance lorsque la volatilité s'étend. Notamment, le Quantum ML Engine qualifie son chiffre de taux de réussite de courte « calibration, pas un backtest » — un rappel honnête qu'un taux de réussite récent sur une petite fenêtre est un contrôle de santé de la calibration actuelle du modèle, pas une promesse de performance future. Traiter chaque lecture comme un contexte probabiliste plutôt qu'une garantie est le bon état d'esprit pour tout indicateur ML.
Dans quoi Lorentzian Classification excelle-t-il, et où échoue-t-il ?
Bien utilisé, Lorentzian Classification a de vraies forces. Il s'adapte aux données réelles au lieu de supposer un modèle fixe du marché, sa métrique lorentzienne le rend robuste précisément dans les conditions volatiles où des outils plus simples cassent, contrairement à un outil de moyenne mobile, et une bonne implémentation donne une lecture nuancée et probabiliste, avec confiance et contexte de régime. C'est une lentille réellement différente sur le marché par rapport à la boîte à outils habituelle des moyennes mobiles.
Mais ce n'est pas de la magie, et être honnête sur ses limites distingue les bons utilisateurs de ceux qui seront déçus. Il reste une correspondance de motifs sur données passées : si le futur cesse de ressembler au passé — un véritable changement de régime sans analogue historique — ses voisines deviennent trompeuses. Il ne sait pas pourquoi quoi que ce soit arrive, seulement ce qui avait tendance à suivre des lectures similaires. Il peut être curve-fit par un réglage excessif — raison pour laquelle un backtesting honnête compte — et, comme tout indicateur, il peut produire des séries perdantes. C'est un signal probabiliste de grande qualité à combiner avec la structure, le contexte et une gestion du risque stricte — pas un oracle autonome.
Faut-il trader les signaux Lorentzian seuls ?
La façon productive d'utiliser Lorentzian Classification est de s'en servir comme filtre directionnel de qualité et moteur de contexte, pas comme déclencheur achat/vente aveugle. Laissez le classificateur vous indiquer quel côté a l'edge historique maintenant et avec quelle confiance, puis exigez votre propre confirmation avant d'agir — un market-structure shift dans la même direction, un niveau clé ou un signal d'entrée séparé. La classification fixe le biais ; votre structure et votre plan de risque fixent le trade.
Transformer le classificateur en signal filtré
Filtrez la classification brute par confiance et régime, puis exigez votre propre confirmation.
Il se combine aussi naturellement avec la même discipline que réclame n'importe quel indicateur : donnez davantage de poids aux signaux de plus forte confiance, respectez le contexte de régime et de volatilité fourni par le tableau de bord, et dimensionnez chaque trade avec une gestion du risque stricte afin qu'aucune mauvaise classification isolée ne fasse de dégâts. Comme le Quantum ML Engine expose explicitement la confiance, le régime et la volatilité, vous pouvez construire des règles simples — par exemple ne prendre que les signaux au-dessus d'un seuil de confiance dans un régime de tendance — qui transforment un classificateur brut en système discipliné et filtré.
• Moteur Adaptive Lorentzian — Adaptive K, détection de régime et de volatilité avec score de confiance
• Calibration honnête — Une lecture de calibration transparente, explicitement non présentée comme un backtest
• Performance vérifiable — Un historique public vérifié derrière chaque signal
◆ Essayez le moteur Adaptive Lorentzian
L'Adaptive Lorentzian Classification de Quantum Algo — le Quantum ML Engine présenté ci-dessus — apporte à vos graphiques l'Adaptive K, la détection de régime et de volatilité, le score de confiance et une calibration honnête, superposés au même contexte Smart Money Concepts que le reste de la suite, le tout soutenu par un historique public vérifié.
Voir le script sur TradingView → Vérifier l'historiqueQuestions fréquentes
Lorentzian Classification est un indicateur machine learning qui traite le trading comme un problème de reconnaissance de motifs. Il utilise un modèle k-nearest-neighbours pour trouver les bougies historiques les plus similaires aux conditions actuelles et classe le prochain mouvement probable selon la façon dont ces situations passées similaires se sont résolues. Sa caractéristique déterminante est l'utilisation de la distance lorentzienne — plutôt que la distance euclidienne ordinaire — pour mesurer la similarité, ce qui le rend plus robuste dans les marchés volatils.
Chaque bougie historique est stockée comme un point dans un espace des features dont les axes sont des lectures d'indicateurs comme le RSI, un oscillateur Wave Trend et l'ADX. Lorsqu'une nouvelle bougie se forme, le modèle mesure sa distance lorentzienne à chaque bougie stockée, conserve les k « nearest neighbours » les plus proches, puis regarde comment le prix s'est résolu après chacune. Si la plupart des bougies passées similaires ont été suivies de mouvements haussiers, la bougie actuelle est classée haussière ; si la plupart ont mené à des mouvements baissiers, elle est classée baissière. Le signal est le vote agrégé de ces analogues historiques.
La distance lorentzienne est une façon de mesurer à quel point deux instantanés de marché diffèrent, empruntée aux mathématiques de l'espace-temps. Contrairement à la distance euclidienne, qui élève les différences au carré et laisse donc un seul grand écart dominer, la distance lorentzienne ne croît que logarithmiquement avec les grandes différences. Cela signifie qu'une lecture extrême et volatile ne fait pas exploser la mesure de similarité ; les bougies similaires mais volatiles restent donc proches et le modèle trouve des situations historiques vraiment comparables même dans les marchés turbulents — précisément lorsque les analogues fiables comptent le plus.
Oui, légitimement — k-nearest-neighbours est l'un des algorithmes de machine learning les plus anciens et les mieux établis. C'est du « machine learning » au sens où il classe de nouvelles données en apprenant d'exemples historiques étiquetés, plutôt qu'en suivant des règles codées à la main. Ce n'est toutefois pas un réseau neuronal ni un grand modèle qui « comprend » les marchés ; c'est un classificateur fondé sur la similarité. Cette distinction compte : il est puissant et adaptatif, mais il fait de la correspondance de motifs sur l'historique, pas du raisonnement causal.
K est le nombre de nearest neighbours que le modèle utilise pour voter sur la classification. Un petit K rend l'indicateur réactif mais bruyant ; un grand K lisse le vote mais peut brouiller de vrais signaux. « Adaptive K » signifie que l'implémentation ajuste ce nombre selon les conditions de marché au lieu de le fixer — par exemple, le Quantum ML Engine affiche un Adaptive K de 6/8, ce qui signifie qu'il utilise actuellement six voisines sur huit possibles compte tenu du régime et de la volatilité détectés.
Il décrit généralement chaque bougie avec un petit ensemble de lectures techniques normalisées — couramment un oscillateur de momentum comme le RSI, une mesure de type Wave Trend ou CCI, et une mesure de force de tendance comme l'ADX. Elles deviennent les coordonnées de la bougie dans l'espace des features où la similarité est mesurée. Les bonnes implémentations gardent l'ensemble de features compact, normalisé et complémentaire, car trop peu de features ne distinguent pas les situations, tandis que trop de features déclenchent la « malédiction de la dimensionnalité » qui donne à chaque bougie une apparence équidistante.
Une version correctement construite qui classe sur bougies clôturées ne repaint pas — une fois qu'une bougie clôture, ses features et sa classification sont fixées. Cependant, les implémentations varient, et certaines affichent des mises à jour en temps réel sur la bougie en formation qui se stabilisent à la clôture. Si vous vous appuyez sur les signaux, vérifiez le script précis en le regardant se former en direct et en confirmant que les classifications historiques ne se déplacent pas au rechargement. Comme avec tout indicateur, ne faites confiance qu'à ce qui tient dans des tests en temps réel sur bougies clôturées.
Le taux de réussite de calibration est un taux de réussite récent que le modèle rapporte sur une courte fenêtre comme contrôle de santé de sa calibration actuelle. Point important, le Quantum ML Engine l'étiquette explicitement comme une calibration « pas un backtest » — un rappel honnête qu'un taux de réussite sur un petit échantillon récent est une jauge de la façon dont le modèle est actuellement réglé, pas une projection de performance future. Il doit être lu comme un contexte probabiliste avec le signal, la confiance, le régime et la volatilité, jamais comme une garantie.
Il fait de la correspondance de motifs sur données passées ; donc, si le futur cesse de ressembler au passé — un véritable changement de régime sans analogue historique — ses nearest neighbours deviennent trompeuses et son edge s'affaiblit. Il ne sait pas pourquoi quoi que ce soit arrive, seulement ce qui avait tendance à suivre des lectures similaires. Il peut être curve-fit par un réglage excessif et, comme tout indicateur, il produit des séries perdantes. Il vaut mieux le traiter comme un signal probabiliste de grande qualité à combiner avec la structure de marché, le contexte et une gestion du risque stricte — pas comme un oracle autonome.
Utilisez-le comme filtre directionnel et moteur de contexte plutôt que comme déclencheur aveugle. Laissez le classificateur vous dire quel côté a l'edge historique et avec quelle confiance, puis exigez votre propre confirmation — un market-structure shift dans la même direction, un niveau clé ou un signal d'entrée séparé — avant d'agir. Comme des implémentations telles que le Quantum ML Engine exposent explicitement la confiance, le régime et la volatilité, vous pouvez construire des règles simples, par exemple ne prendre que les signaux au-dessus d'un seuil de confiance dans un régime de tendance, transformant un classificateur brut en système discipliné.
Il est différent plutôt que strictement meilleur. Les moyennes mobiles sont simples, transparentes et retardent par conception ; Lorentzian Classification est adaptatif, robuste à la volatilité et fournit un contexte probabiliste avec confiance et régime, mais il est plus complexe et dépend du fait que l'historique ressemble au présent. Beaucoup de traders les trouvent complémentaires — une moyenne mobile ou un outil de canal pour un contexte de tendance propre, et un classificateur Lorentzian pour une lecture directionnelle nuancée. Aucun des deux ne remplace la structure et la gestion du risque.
Quantum Algo publie un Adaptive Lorentzian Classification — le Quantum ML Engine montré dans ce guide — sur TradingView. Il ajoute l'Adaptive K, la détection de régime et de volatilité, le score de confiance et une calibration honnête par-dessus la méthode k-NN lorentzienne centrale, et superpose le même contexte Smart Money Concepts que le reste de la suite. Vous pouvez voir le script directement sur TradingView, et ses signaux sont soutenus par l'historique public vérifié de Quantum Algo.
Références et guides associés
Plus dans ce sujet
- Indicateurs de trading machine learning (Lorentzian) : guide complet
- SuperTrend AI (Clustering) : guide complet
- Journal de trading IA : comment l'utiliser pour vraiment progresser
- Guide de l'indicateur Gaussian Channel
- Meilleurs indicateurs TradingView
- Indicateurs non-repaint : le guide complet des signaux fiables
- Guide de l'indicateur RSI
- Indicateur Squeeze Momentum (TTM Squeeze) : guide complet
- Meilleur indicateur d'achat/vente : comment choisir celui qui fonctionne vraiment
- Backtesting d'une stratégie de trading — guide complet de validation
- Smart Money Concepts (SMC) : guide de trading ultime
- Stratégie de trend trading : le guide complet
- Meilleurs bots de trading — classement : automatisez votre trading
- Guide de l'indicateur Supertrend
Lectures essentielles
- Indicateurs de trading machine learning (Lorentzian) : guide complet
- Meilleurs indicateurs TradingView
- Gestion du risque en trading — le guide complet de survie
- Tous les guides premium
- Historique public
- Quantum Algo sur TradingView