Lorentzian Classification: der komplette Machine-Learning-Guide
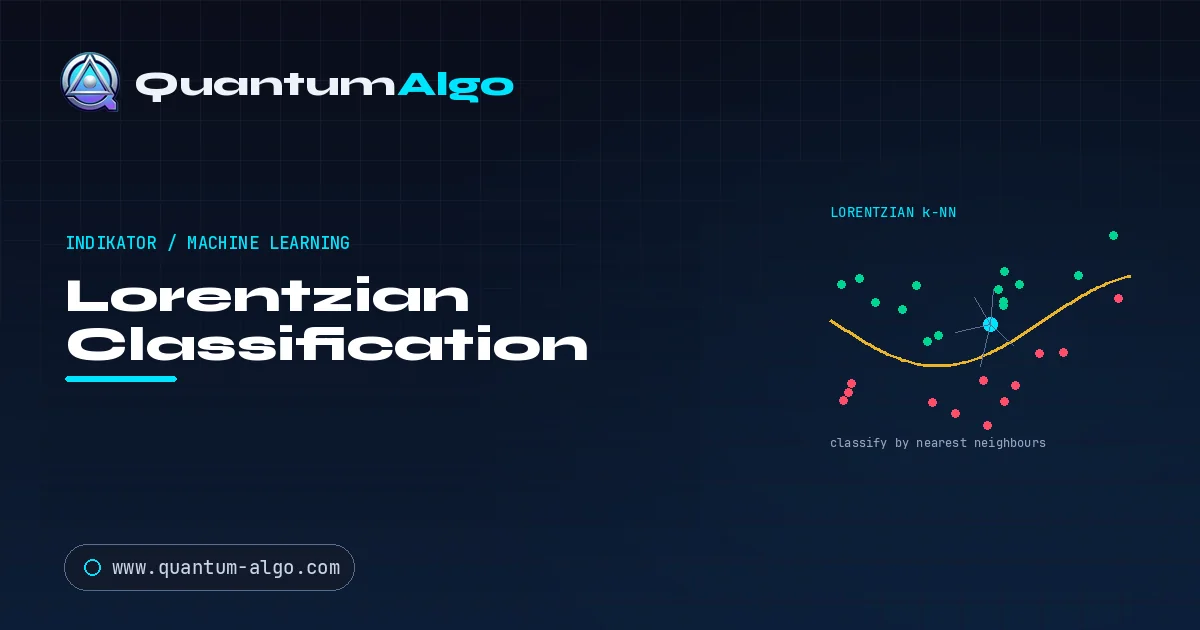
Lorentzian Classification ist ein k-nearest-neighbors-Indikator, der die historischen Kerzen findet, die der aktuellen am ähnlichsten sind, und daraus die Richtung ableitet, je nachdem, wie sich diese Nachbarn aufgelöst haben. Er misst Ähnlichkeit mit Lorentzian Distance statt mit Euclidean Distance. Dadurch werden extreme Werte komprimiert, sodass volatile Märkte die Suche weniger verzerren. Die Anzahl der Nachbarn, k, legt die Sensitivität fest; adaptive Versionen passen k an die Marktbedingungen an.
Lorentzian Classification ist einer der meistdiskutierten Machine-Learning-Indikatoren auf TradingView, und das aus gutem Grund: Statt der üblichen Moving Averages und Schwellenwerte behandelt er Trading wie ein Problem der Mustererkennung. Er betrachtet die aktuellen Marktbedingungen, sucht in der Historie nach den ähnlichsten früheren Situationen und klassifiziert den wahrscheinlich nächsten Move danach, was damals passiert ist — mit einem ungewöhnlichen Distanzmaß, der Lorentzian Distance, das volatile Märkte sauberer verarbeitet als gewöhnliche Geometrie.
Dieser Leitfaden erklärt, was Lorentzian Classification wirklich ist, wie die Idee der k-nearest-neighbours und die Lorentzian Distance in einfacher Sprache funktionieren, was Features und Settings bedeuten und wie du den Indikator sinnvoll nutzt, ohne in die typischen "AI Indicator"-Fallen zu tappen. Außerdem geht er ein Live-Beispiel mit Quantum Algos eigener Adaptive-Lorentzian-Implementierung durch, damit du das Konzept auf einem echten Chart siehst.
Welche Art von Modell ist Lorentzian Classification?
Im Kern ist Lorentzian Classification ein k-nearest-neighbours-(k-NN)-Classifier, angewendet auf den Preis. k-NN ist eine der ältesten und intuitivsten Machine-Learning-Methoden: Um ein neues Beispiel zu klassifizieren, suchst du die k ähnlichsten früheren Beispiele und lässt sie abstimmen. Auf Trading übertragen ist jedes "Beispiel" ein Snapshot der Marktbedingungen auf einer Kerze — beschrieben durch eine Handvoll Indikatorwerte — und das Label ist, was der Preis danach gemacht hat. Die aktuelle Kerze wird klassifiziert, indem die ähnlichsten historischen Kerzen gefunden werden und geprüft wird, ob danach überwiegend Up Moves oder Down Moves kamen.
Was diesen speziellen Indikator besonders macht, ist die Wahl der Distanz. Um zu entscheiden, welche früheren Kerzen "am ähnlichsten" sind, brauchst du eine Methode, den Abstand zwischen zwei Markt-Snapshots zu messen. Die meisten Methoden nutzen Euclidean Distance — gewöhnliche Geometrie mit geraden Linien. Lorentzian Classification nutzt stattdessen Lorentzian Distance, ein Maß aus der Mathematik der Raumzeit, das den Effekt großer Unterschiede komprimiert. In der Praxis heißt das: Extreme, volatile Werte verzerren die Ähnlichkeitssuche weniger, sodass die gefundenen Nachbarn in turbulenten Märkten tendenziell wirklich vergleichbarer sind.

Automatisiere deine Trades. Lass Quantum Algo für dich handeln.
Jedes Signal wird auf deinem eigenen Konto ausgeführt — 24/7, hands-off.
Wie klassifizieren k-nearest-neighbours die aktuelle Kerze?
Die Mechanik ist als Sequenz leichter zu verstehen. Jede historische Kerze wird als Punkt in einem "Feature Space" gespeichert, dessen Achsen die Indikatorwerte dieser Kerze sind. Wenn eine neue Kerze entsteht, setzt das Modell sie in denselben Raum und misst die Lorentzian Distance zu jedem gespeicherten Punkt. Es behält die k nächsten — die nearest neighbours — und schaut, wie sich der Preis nach jedem davon aufgelöst hat. Wenn auf die meisten ähnlichen früheren Situationen ein Up Move folgte, wird die aktuelle Kerze bullish klassifiziert; führten die meisten zu Down Moves, dann bearish.
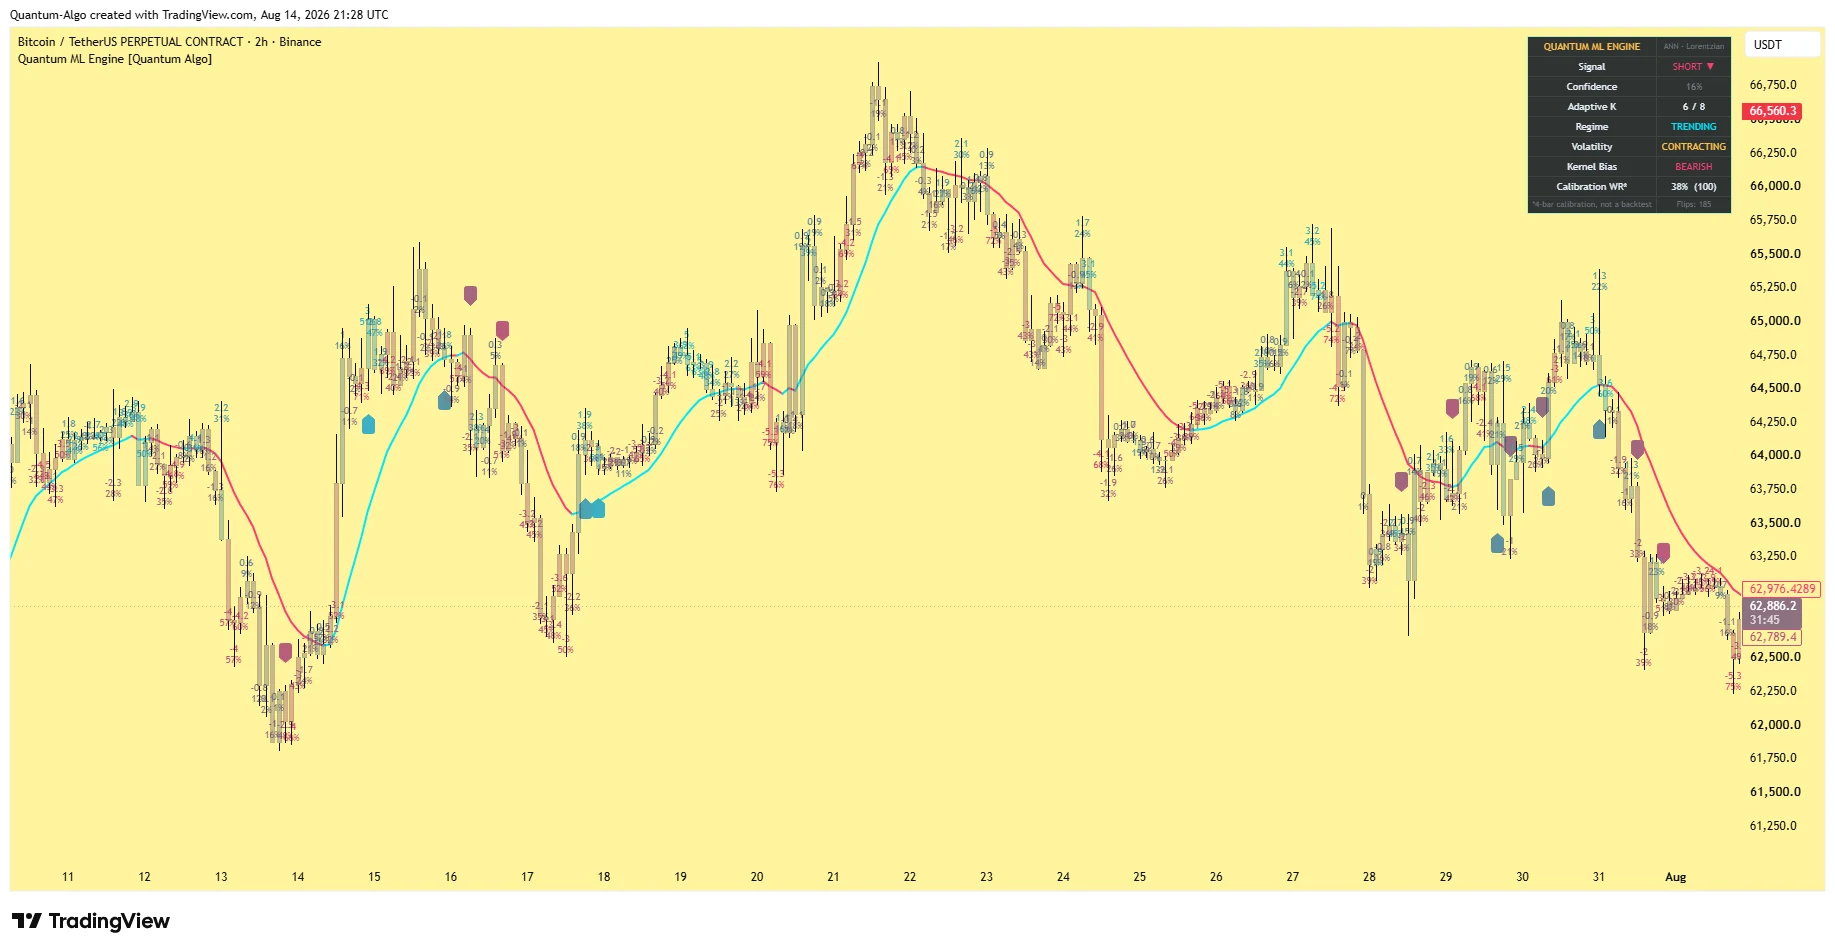
Die Zahl k ist wichtig. Ein kleines k macht das Modell sensibel und reaktiv, aber auch noisier; ein großes k glättet die Abstimmung, kann echte Signale aber verwischen. Genau deshalb passen adaptive Implementierungen, wie AI-clustered Supertrend, k an die Bedingungen an, statt es festzunageln — die Quantum ML Engine im Chart oben zeigt ein "Adaptive K" von 6/8, was bedeutet, dass sie aktuell sechs von möglichen acht Nachbarn auf Basis des Marktstatus nutzt. Die Klassifizierung, die du siehst, ist die aggregierte Abstimmung dieser historischen Analogien.
Die aktuelle Kerze nach ihren Nachbarn klassifizieren
Finde die k ähnlichsten historischen Kerzen und stimme dann über die Richtung ab, je nachdem, wie sie sich aufgelöst haben.
Warum Ähnlichkeit mit Lorentzian statt Euclidean Distance messen?
Die Distanzmetrik ist das Herzstück dessen, was diesen Indikator anders macht, deshalb lohnt sich ein intuitives Verständnis. Stell dir zwei Markt-Snapshots vor, die in den meisten Punkten ähnlich sind, sich aber bei einem volatilen Wert stark unterscheiden — etwa einem Momentum-Spike. Euclidean Distance quadriert Unterschiede, dadurch dominiert diese eine große Lücke die Berechnung und schiebt die beiden Snapshots weit auseinander, obwohl sie sonst ähnlich sind. Das Modell würde dann eine wirklich vergleichbare historische Kerze übersehen.
Euclidean vs. Lorentzian Distance
Euclidean-Quadrierung lässt eine große Lücke dominieren; Lorentzian wächst nur logarithmisch und bleibt robust.
Lorentzian Distance wächst bei großen Unterschieden nur logarithmisch, sodass ein einzelner Extremwert das Ähnlichkeitsmaß nicht sprengt. Ähnliche, aber volatile Kerzen bleiben im Feature Space nah beieinander, ergänzend zu Tools wie dem Gaussian Channel. Dadurch findet die nearest-neighbour-Suche in turbulenten Märkten mehr wirklich analoge Situationen — genau dann, wenn verlässliche Analogien am wertvollsten sind. Diese Robustheit gegenüber Volatilität und Ausreißern ist der ganze Grund, warum die Lorentzian-Metrik gewählt wurde, und deshalb verhält sich der Indikator in chaotischer Price Action oft sinnvoller als ein Classifier mit einfacher Geometrie.
Euclidean vs. Lorentzian Distance auf einen Blick
| Eigenschaft | Euclidean Distance | Lorentzian Distance |
|---|---|---|
| Term pro Feature | Quadrierter Unterschied | Log von 1 plus absoluter Unterschied |
| Wachstum bei großen Lücken | Quadratisch | Logarithmisch |
| Ein Extremwert | Dominiert die Gesamtdistanz | Komprimiert, kann nicht dominieren |
| Ähnliche Kerzen in volatilen Märkten | Werden weit auseinander geschoben | Bleiben nah beieinander |
| Neighbour-Suche in turbulenten Märkten | Findet weniger echte Analogien | Findet mehr analoge Kerzen |
◆Beide Metriken arbeiten mit denselben normalisierten Features; nur die Gewichtung der Unterschiede ändert sich.
Was sieht das Modell tatsächlich auf jeder Kerze?
Ein k-NN-Classifier ist nur so gut wie die Features, die jede Kerze beschreiben. Lorentzian Classification beschreibt Marktbedingungen typischerweise mit einem kleinen Set normalisierter technischer Werte — häufig Momentum- und Trend-Oszillatoren wie RSI, einem Wave Trend oder CCI-ähnlichen Maß sowie ADX für Trendstärke. Jede Kerze wird zu einer kurzen Liste dieser Werte, und diese Liste sind ihre Koordinaten im Feature Space, in dem Ähnlichkeit gemessen wird.
Auswahl und Anzahl der Features prägen alles, was danach kommt. Zu wenige, und das Modell kann sinnvoll unterschiedliche Situationen nicht unterscheiden; zu viele, und der "curse of dimensionality" lässt jede Kerze ungefähr gleich weit entfernt wirken, was die Nachbarsuche schwächt. Gute Implementierungen halten das Feature Set kompakt, normalisiert und komplementär — jedes Feature erfasst einen anderen Marktaspekt — damit "nearest" im Feature Space wirklich "am ähnlichsten" im Markt bedeutet.
Momentum-Features
Werte wie RSI oder ein Wave Trend Oscillator erfassen, ob der Markt überdehnt ist oder Energie aufbaut, ähnlich wie ein Squeeze-Momentum-Read — ein Kernbestandteil dafür, was zwei Situationen vergleichbar macht.
Trend-Features
Ein Trendstärkemaß wie ADX sagt dem Modell, ob ein Snapshot aus einem trendenden oder seitwärts laufenden Umfeld stammt, was stark beeinflusst, was als Nächstes passiert.
Normalisierung
Features werden auf vergleichbare Bereiche skaliert, damit keines nur wegen seiner Einheit die Distanz dominiert — eine Voraussetzung für jedes distanzbasierte Modell.
Kompaktes Set
Eine Handvoll komplementärer Features schlägt einen großen Haufen korrelierter Werte, weil die Nachbarsuche dadurch aussagekräftig bleibt, statt verwässert zu werden.
Das Quantum-ML-Engine-Dashboard lesen
Der Chart oben zeigt Quantum Algos Adaptive-Lorentzian-Implementierung, und ihr Dashboard macht den internen Zustand des Modells sichtbar — ein guter Weg, um zu lernen, was der Indikator macht. Jede Zeile ist ein Live-Output des Classifiers und seiner unterstützenden Logik. Du siehst also nicht nur ein Signal, sondern auch den Kontext dahinter.
Was jede Dashboard-Zeile dir sagt
Das Signal ist die Abstimmung; die anderen Zeilen zeigen dir, wie sehr du ihr vertrauen solltest und welches Regime sie erzeugt hat.
Die wichtigste Gewohnheit ist, das Signal im Kontext zu lesen. Ein Short-Signal mit niedriger Confidence in einem trendenden Regime mit kontrahierender Volatilität ist etwas völlig anderes als ein Signal mit hoher Confidence, während Volatilität expandiert. Bemerkenswert ist, dass die Quantum ML Engine ihre Win-Rate-Zahl als kurze "Kalibrierung, kein Backtest" kennzeichnet — eine ehrliche Erinnerung daran, dass eine jüngste Hit-Rate über ein kleines Fenster ein Gesundheitscheck für die aktuelle Modellkalibrierung ist, kein Versprechen für künftige Performance. Jede Ausgabe als probabilistischen Kontext statt als Garantie zu behandeln, ist bei jedem ML-Indikator das richtige Mindset.
Worin ist Lorentzian Classification gut, und wo scheitert sie?
Richtig genutzt hat Lorentzian Classification echte Stärken. Sie passt sich an die tatsächlichen Daten an, statt ein fixes Marktmodell zu unterstellen. Ihre Lorentzian-Metrik macht sie genau in den volatilen Bedingungen robust, in denen einfachere Tools brechen, anders als ein Moving-Average-Tool. Und eine gute Implementierung liefert einen nuancierten, probabilistischen Read inklusive Confidence und Regime-Kontext. Sie ist eine wirklich andere Linse auf den Markt als das übliche Moving-Average-Toolkit.
Aber sie ist keine Magie, und Ehrlichkeit über ihre Grenzen trennt gute Nutzer von enttäuschten. Es bleibt Pattern Matching auf Vergangenheitsdaten: Wenn die Zukunft der Vergangenheit nicht mehr ähnelt — ein echter Regimewechsel ohne historische Analogie — werden ihre Nachbarn irreführend. Sie weiß nicht, warum etwas passiert, sondern nur, was ähnlichen Werten tendenziell folgte. Sie kann durch Over-Tuning curve-fit werden — deshalb ist ehrliches Backtesting wichtig — und wie jeder Indikator kann sie Losing Streaks produzieren. Sie ist ein hochwertiges probabilistisches Signal, das du mit Struktur, Kontext und strengem Risikomanagement kombinierst — kein alleinstehendes Orakel.
Solltest du Lorentzian-Signale allein traden?
Der produktive Weg, Lorentzian Classification zu nutzen, ist als hochwertiger Richtungsfilter und Kontext-Engine, nicht als blinder Buy/Sell-Trigger. Lass dir vom Classifier sagen, welche Seite gerade den historischen Edge hat und wie sicher er ist, und verlange dann deine eigene Bestätigung, bevor du handelst — einen Market-Structure-Shift in dieselbe Richtung, ein Key Level oder ein separates Entry Signal. Die Klassifizierung setzt den Bias; deine Struktur und dein Risikoplan setzen den Trade.
Aus dem Classifier ein gefiltertes Signal machen
Filtere die rohe Klassifizierung mit Confidence und Regime und verlange dann deine eigene Bestätigung.
Er passt außerdem natürlich zu derselben Disziplin, die jeder Indikator verlangt: Gewichte Signale mit höherer Confidence stärker, respektiere den Regime- und Volatilitätskontext aus dem Dashboard und size jeden Trade mit strengem Risikomanagement, damit keine einzelne Fehlklassifizierung wehtut. Weil die Quantum ML Engine Confidence, Regime und Volatilität explizit zeigt, kannst du einfache Regeln bauen — zum Beispiel nur Signale oberhalb einer Confidence-Schwelle in einem trendenden Regime zu nehmen — die aus einem rohen Classifier ein diszipliniertes, gefiltertes System machen.
• Adaptive Lorentzian Engine — Adaptive K, Regime- und Volatilitätserkennung mit Confidence Scoring
• Ehrliche Kalibrierung — Ein transparenter Kalibrierungs-Read, ausdrücklich nicht als Backtest dargestellt
• Nachvollziehbare Performance — Ein verifizierter öffentlicher Track Record hinter jedem Signal
◆ Teste die Adaptive Lorentzian Engine
Quantum Algos Adaptive Lorentzian Classification — die oben gezeigte Quantum ML Engine — bringt Adaptive K, Regime- und Volatilitätserkennung, Confidence Scoring und ehrliche Kalibrierung in deine Charts, kombiniert mit demselben Smart Money Concepts-Kontext wie der Rest der Suite und gestützt durch einen verifizierten öffentlichen Track Record.
Script auf TradingView ansehen → Track Record verifizierenHäufig gestellte Fragen
Lorentzian Classification ist ein Machine-Learning-Indikator, der Trading als Problem der Mustererkennung behandelt. Er nutzt ein k-nearest-neighbours-Modell, um die historischen Kerzen zu finden, die den aktuellen Bedingungen am ähnlichsten sind, und klassifiziert den wahrscheinlich nächsten Move danach, wie sich diese ähnlichen früheren Situationen aufgelöst haben. Sein definierendes Merkmal ist die Nutzung von Lorentzian Distance — statt gewöhnlicher Euclidean Distance — zur Messung von Ähnlichkeit, was ihn in volatilen Märkten robuster macht.
Jede historische Kerze wird als Punkt in einem Feature Space gespeichert, dessen Achsen Indikatorwerte wie RSI, ein Wave Trend Oscillator und ADX sind. Wenn eine neue Kerze entsteht, misst das Modell die Lorentzian Distance von ihr zu jeder gespeicherten Kerze, behält die k nächsten "nearest neighbours" und schaut, wie sich der Preis nach jeder davon aufgelöst hat. Wenn auf die meisten ähnlichen früheren Kerzen Up Moves folgten, wird die aktuelle Kerze bullish klassifiziert; führten die meisten zu Down Moves, dann bearish. Das Signal ist die aggregierte Abstimmung dieser historischen Analogien.
Lorentzian Distance ist eine Methode, zu messen, wie unterschiedlich zwei Markt-Snapshots sind, entlehnt aus der Mathematik der Raumzeit. Anders als Euclidean Distance, die Unterschiede quadriert und dadurch eine einzelne große Lücke dominieren lässt, wächst Lorentzian Distance bei großen Unterschieden nur logarithmisch. Das heißt: Ein extremer, volatiler Wert sprengt das Ähnlichkeitsmaß nicht. Ähnliche, aber volatile Kerzen bleiben nah beieinander, und das Modell findet selbst in turbulenten Märkten wirklich vergleichbare historische Situationen — genau dann, wenn verlässliche Analogien am wichtigsten sind.
Ja, legitim — k-nearest-neighbours ist einer der ältesten und etabliertesten Machine-Learning-Algorithmen. Es ist "Machine Learning" in dem Sinne, dass neue Daten klassifiziert werden, indem aus gelabelten historischen Beispielen gelernt wird, statt starren handgeschriebenen Regeln zu folgen. Es ist aber kein neuronales Netz und kein großes Modell, das Märkte "versteht"; es ist ein ähnlichkeitbasierter Classifier. Dieser Unterschied zählt: Es ist kraftvoll und adaptiv, aber es ist Pattern Matching auf Historie, kein Denken über Ursachen.
K ist die Anzahl der nearest neighbours, die das Modell für die Abstimmung über die Klassifizierung nutzt. Ein kleines K macht den Indikator reaktiv, aber noisy; ein großes K glättet die Abstimmung, kann echte Signale aber verwischen. "Adaptive K" bedeutet, dass die Implementierung diese Zahl auf Basis der Marktbedingungen anpasst, statt sie festzulegen — zum Beispiel zeigt die Quantum ML Engine ein Adaptive K von 6/8, was bedeutet, dass sie angesichts des erkannten Regimes und der Volatilität aktuell sechs von möglichen acht Nachbarn nutzt.
Typischerweise beschreibt sie jede Kerze mit einem kleinen Set normalisierter technischer Werte — häufig einem Momentum-Oszillator wie RSI, einem Wave Trend oder CCI-ähnlichen Maß und einem Trendstärkemaß wie ADX. Diese werden zu den Koordinaten der Kerze im Feature Space, in dem Ähnlichkeit gemessen wird. Gute Implementierungen halten das Feature Set kompakt, normalisiert und komplementär, weil zu wenige Features Situationen nicht unterscheiden können und zu viele den "curse of dimensionality" auslösen, durch den jede Kerze gleich weit entfernt wirkt.
Eine sauber gebaute Version, die auf geschlossenen Kerzen klassifiziert, repaintet nicht — sobald eine Kerze schließt, sind ihre Features und ihre Klassifizierung fix. Implementierungen unterscheiden sich aber, und manche zeigen Echtzeit-Updates auf der gerade entstehenden Kerze, die sich beim Schluss der Kerze stabilisieren. Wenn du dich auf die Signale verlässt, prüfe das konkrete Script, indem du es live beim Entstehen beobachtest und bestätigst, dass historische Klassifizierungen beim Neuladen nicht wandern. Wie bei jedem Indikator solltest du nur dem vertrauen, was Closed-Bar- und Echtzeit-Tests standhält.
Die Calibration Win Rate ist eine jüngste Hit-Rate, die das Modell über ein kurzes Fenster als Gesundheitscheck seiner aktuellen Kalibrierung ausgibt. Wichtig: Die Quantum ML Engine kennzeichnet sie ausdrücklich als Kalibrierung, "not a backtest" — eine ehrliche Erinnerung daran, dass eine Hit-Rate über eine kleine jüngste Stichprobe ein Maß dafür ist, wie gut das Modell aktuell abgestimmt ist, keine Projektion künftiger Performance. Sie sollte als probabilistischer Kontext neben Signal, Confidence, Regime und Volatilität gelesen werden, niemals als Garantie.
Sie ist Pattern Matching auf Vergangenheitsdaten. Wenn die Zukunft der Vergangenheit also nicht mehr ähnelt — ein echter Regimewechsel ohne historische Analogie — werden ihre nearest neighbours irreführend und ihre Edge wird schwächer. Sie weiß nicht, warum etwas passiert, sondern nur, was ähnlichen Werten tendenziell folgte. Sie kann durch Over-Tuning curve-fit werden und produziert wie jeder Indikator Losing Streaks. Am besten behandelst du sie als hochwertiges probabilistisches Signal, das du mit Market Structure, Kontext und strengem Risikomanagement kombinierst — nicht als alleinstehendes Orakel.
Nutze sie als Richtungsfilter und Kontext-Engine statt als blinden Trigger. Lass dir vom Classifier sagen, welche Seite den historischen Edge hat und wie sicher er ist, und verlange dann deine eigene Bestätigung — einen Market-Structure-Shift in dieselbe Richtung, ein Key Level oder ein separates Entry Signal — bevor du handelst. Weil Implementierungen wie die Quantum ML Engine Confidence, Regime und Volatilität explizit zeigen, kannst du einfache Regeln bauen, etwa nur Signale oberhalb einer Confidence-Schwelle in einem trendenden Regime zu nehmen, und so aus einem rohen Classifier ein diszipliniertes System machen.
Sie ist eher anders als strikt besser. Moving Averages sind einfach, transparent und hinken absichtlich hinterher; Lorentzian Classification ist adaptiv, robust gegenüber Volatilität und liefert probabilistischen Kontext mit Confidence und Regime, ist aber komplexer und hängt davon ab, dass die Historie der Gegenwart ähnelt. Viele Trader finden beides komplementär — ein Moving-Average- oder Channel-Tool für sauberen Trendkontext und einen Lorentzian Classifier für einen nuancierten Richtungs-Read. Nichts davon ersetzt Struktur und Risikomanagement.
Quantum Algo veröffentlicht eine Adaptive Lorentzian Classification — die in diesem Guide gezeigte Quantum ML Engine — auf TradingView. Sie ergänzt die zentrale Lorentzian-k-NN-Methode um Adaptive K, Regime- und Volatilitätserkennung, Confidence Scoring und ehrliche Kalibrierung und legt denselben Smart Money Concepts-Kontext darüber wie der Rest der Suite. Du kannst das Script direkt auf TradingView ansehen, und seine Signale werden durch Quantum Algos verifizierten öffentlichen Track Record gestützt.
Quellen & verwandte Leitfäden
Mehr zu diesem Thema
- Machine Learning Trading Indicators (Lorentzian): kompletter Leitfaden
- SuperTrend AI (Clustering): der komplette Guide
- AI Trading Journal: Wie du eines wirklich zur Verbesserung nutzt
- Gaussian-Channel-Indikator-Guide
- Beste TradingView-Indikatoren
- Non-Repaint-Indikatoren: der komplette Leitfaden zu verlässlichen Signalen
- RSI-Indikator-Guide
- Squeeze Momentum Indicator (TTM Squeeze): kompletter Guide
- Best Buy/Sell Indicator: Wie du einen wählst, der wirklich funktioniert
- Backtesting Trading Strategy — kompletter Validierungsleitfaden
- Smart Money Concepts (SMC): ultimativer Trading-Leitfaden
- Trend-Trading-Strategie: der komplette Guide
- Best Trading Bots — Ranking: automatisiere dein Trading
- Supertrend-Indikator-Guide
Grundlagenlektüre
- Machine Learning Trading Indicators (Lorentzian): kompletter Leitfaden
- Beste TradingView-Indikatoren
- Risikomanagement im Trading — der komplette Überlebensleitfaden
- Alle Premium-Leitfäden
- Öffentlicher Track Record
- Quantum Algo auf TradingView