Lorentzian Classification:机器学习完整指南
Lorentzian Classification 是一种 k 近邻指标,它会寻找与当前 K线最相似的历史 K线,并根据这些邻居之后的走势来预测方向。它用 Lorentzian 距离而不是 Euclidean 距离来衡量相似性,这会压缩极端读数,让波动剧烈的市场不那么扭曲搜索结果。邻居数量 k 决定灵敏度;自适应版本会根据市场条件调整 k。
Lorentzian Classification 是 TradingView 上讨论度最高的机器学习指标之一,而且理由很充分:它不是使用常见的移动平均线和阈值,而是把交易当成一个模式识别问题。它观察当前市场条件,在历史中搜索最相似的过去情境,并根据那些情境后来发生的结果,对下一步可能走势进行分类;它使用一种不寻常的距离度量 Lorentzian 距离,相比普通几何距离,更能优雅地处理波动市场。
本指南会用通俗语言解释 Lorentzian Classification 到底是什么、k 近邻思路和 Lorentzian 距离如何运作、特征和设置意味着什么,以及如何理性使用它,避免落入常见的“AI 指标”陷阱。它还会用 Quantum Algo 自己的 Adaptive Lorentzian 实现走过一个实时示例,让您在真实图表上看到这个概念。
Lorentzian Classification 属于哪种模型?
从核心上看,Lorentzian Classification 是应用在价格上的 k 近邻(k-NN)分类器。k-NN 是最古老、也最直观的机器学习方法之一:要给一个新样本分类,您先找到k 个最相似的历史样本,然后让它们投票。应用到交易中,每个“样本”都是某根 K线上的市场条件快照,由几个指标数值描述;标签则是价格接下来做了什么。当前 K线会通过寻找最相似的历史 K线来分类,并观察它们之后大多是上涨还是下跌。
这个指标的独特之处在于距离的选择。要判断哪些历史 K线“最相似”,您需要一种衡量两个市场快照之间差距的方法。大多数方法使用 Euclidean 距离,也就是普通的直线几何。Lorentzian Classification 则使用 Lorentzian 距离,这是一种借自时空数学的度量,会压缩大差异的影响。实际效果是,极端、剧烈波动的读数不那么扭曲相似性搜索,因此它找到的邻居在动荡市场中往往更真正可比。
k 近邻如何给当前 K线分类?
把机制拆成一个序列会更容易理解。每根历史 K线都被存储为“特征空间”中的一个点,坐标轴是该 K线上的指标读数。当新 K线形成时,模型会把它放入同一个空间,并测量它到每个已存储点的 Lorentzian 距离。它保留k 个最近的点,也就是最近邻,然后观察它们之后价格如何演化。如果这些相似的过去情境大多随后上涨,当前 K线就被分类为看涨;如果大多随后下跌,就被分类为看跌。
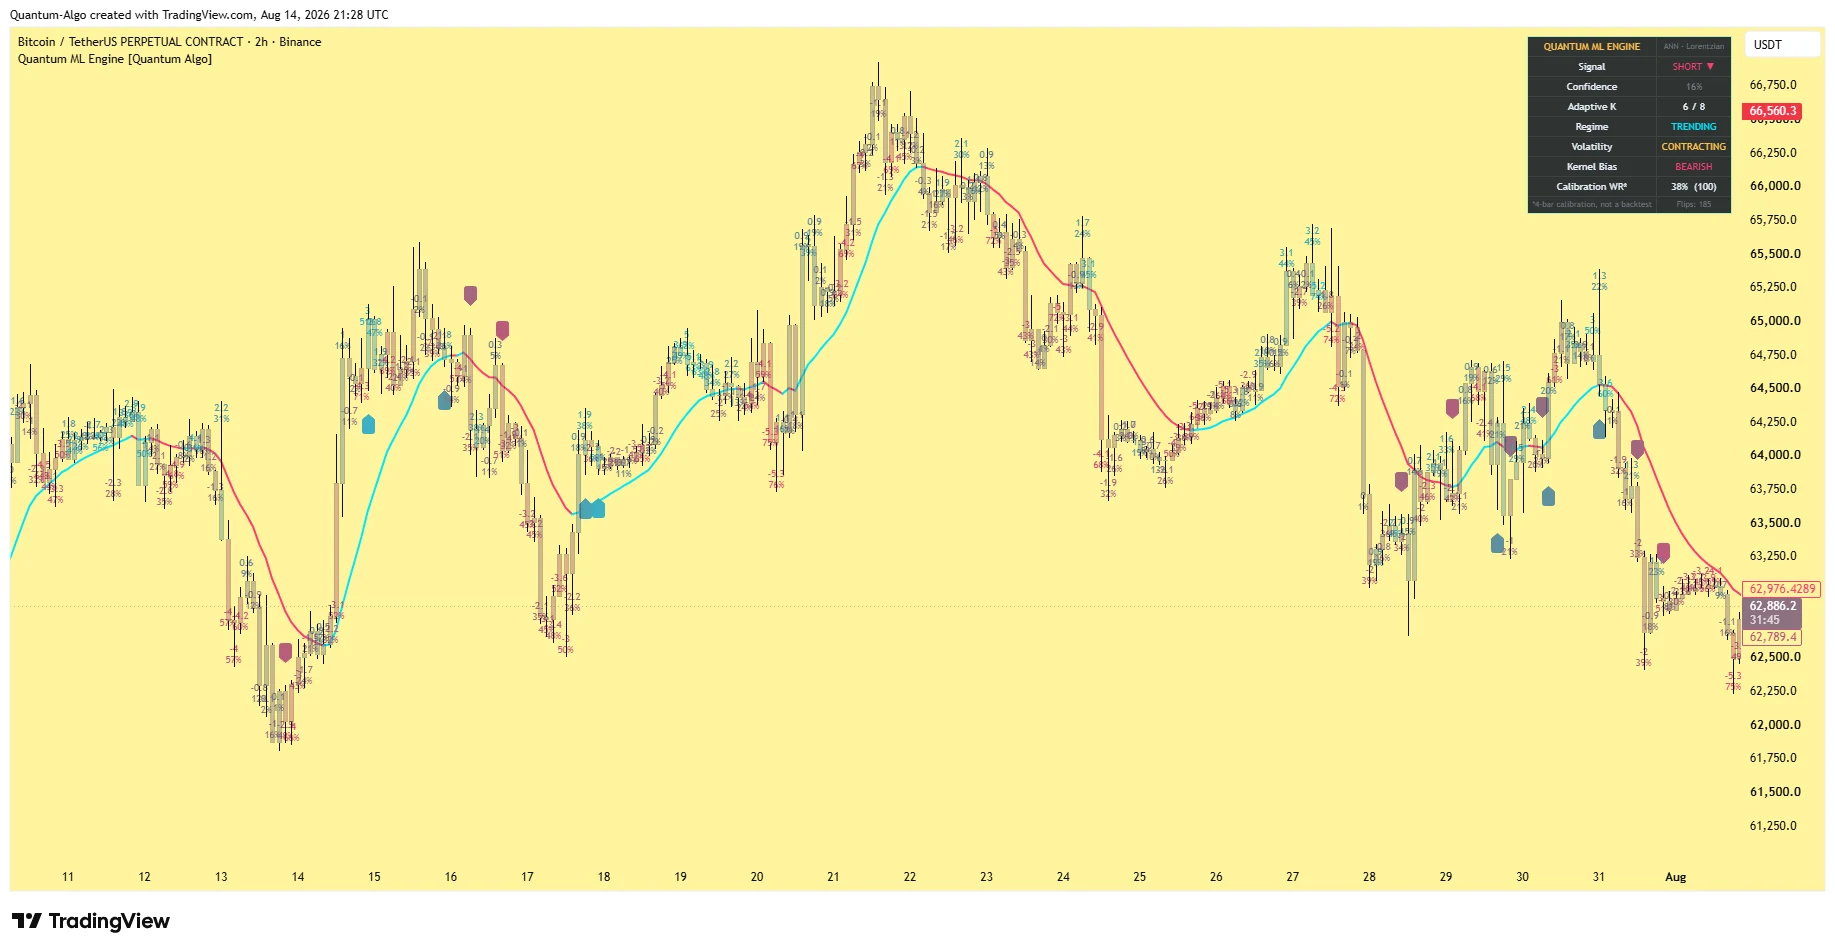
数字 k 很重要。较小的 k 会让模型敏感、反应快,但噪音更大;较大的 k 会平滑投票,却可能模糊真正的信号。这正是为什么像 AI-clustered Supertrend 这样的自适应实现,会根据条件调整 k,而不是固定它。上方图表中的 Quantum ML Engine 显示 “Adaptive K” 为 6/8,意思是它当前会根据市场状态,在最多八个邻居中使用六个。您看到的分类,就是这些历史相似样本的聚合投票。
用邻居给当前 K线分类
找到 k 个最相似的历史 K线,然后根据它们之后的走势投票决定方向。
为什么用 Lorentzian 距离而不是 Euclidean 距离衡量相似性?
距离度量是这个指标与众不同的核心,因此值得用直觉方式理解。想象两个市场快照在大多数方面相似,但在某个波动剧烈的读数上差异很大,例如一次动量尖峰。Euclidean 距离会把差异平方,因此单个巨大差距会主导计算,把两个快照推得很远,即使它们在其他所有方面都很像。模型随后就会忽略一根真正可比的历史 K线。
Euclidean 距离 vs Lorentzian 距离
Euclidean 平方会让一个大差距主导结果;Lorentzian 只按对数增长,因此保持稳健。
Lorentzian 距离只会随大差异按对数增长,因此单个极端读数不会放大到支配相似性度量。相似但波动剧烈的 K线会在特征空间中保持接近,并与 Gaussian Channel 这类工具形成互补;这意味着最近邻搜索能在市场动荡时找到更多真正类似的情境,而这正是可靠类比最有价值的时候。对波动和异常值的稳健性,是选择 Lorentzian 度量的全部原因,也解释了为什么这个指标在混乱价格走势中,常常比普通几何分类器表现得更理性。
Euclidean 与 Lorentzian 距离一览
| 属性 | Euclidean 距离 | Lorentzian 距离 |
|---|---|---|
| 每个特征项 | 平方差 | 1 加绝对差后的对数 |
| 大差距下的增长 | 二次增长 | 对数增长 |
| 一个极端读数 | 主导总距离 | 被压缩,无法主导 |
| 波动市场中的相似 K线 | 被推得很远 | 保持接近 |
| 动荡市场中的邻居搜索 | 找到更少真实类比 | 找到更多类似 K线 |
◆两种度量都作用于同一组标准化特征;变化的只是差异的加权方式。
模型在每根 K线上实际看到了什么?
k-NN 分类器的好坏,取决于描述每根 K线的特征。Lorentzian Classification 通常会用一小组标准化技术读数来描述市场条件,常见的是动量和趋势振荡指标,例如 RSI、Wave Trend 或 CCI 风格的度量,以及用于衡量趋势强度的 ADX。每根 K线都会变成这些数值组成的一小串列表,而这串列表就是它在特征空间中的坐标,相似性也在那里被衡量。
特征的选择和数量会塑造后续一切。太少,模型就无法区分有意义差异的情境;太多,“维度灾难”会让每根 K线看起来都差不多等距,从而削弱邻居搜索。好的实现会让特征集保持紧凑、标准化且互补,每个特征捕捉市场的不同方面,这样特征空间中的“最近”才真正意味着市场意义上的“最相似”。
趋势特征
ADX 这类趋势强度度量,会告诉模型某个快照来自趋势环境还是震荡环境,而这会强烈影响接下来发生什么。
标准化
特征会被缩放到可比范围,避免某个特征仅仅因为单位不同就支配距离;这是任何基于距离的模型的前提。
紧凑集合
少量互补特征胜过一大堆相关特征,这能让邻居搜索保持有意义,而不是被稀释。
读懂 Quantum ML Engine 仪表板
上方图表是 Quantum Algo 的 Adaptive Lorentzian 实现,它的仪表板会让模型内部状态可见,这是学习指标正在做什么的好方法。每一行都是分类器及其支持逻辑的实时输出,所以您看到的不只是一个信号,还有它背后的背景。
每个仪表板行告诉您什么
信号是投票结果;其他行告诉您该有多信任它,以及它来自什么市场状态。
最重要的习惯,是在背景中阅读信号。在波动收缩、趋势市场状态中出现的低信心做空信号,和波动扩张时出现的高信心信号,完全是两回事。尤其值得注意的是,Quantum ML Engine 把它的胜率数字标注为短期“校准,而不是回测”,这是一个诚实提醒:小窗口中的近期命中率,是对模型当前校准状况的健康检查,而不是未来表现承诺。把每个读数都当作概率背景,而不是保证,才是使用任何 ML 指标的正确心态。
Lorentzian Classification 擅长什么,又会在哪里失效?
如果使用得当,Lorentzian Classification 确实有真实优势。它会适应实际数据,而不是假设市场有固定模型;它的 Lorentzian 度量让它在更简单工具容易失效的波动环境中保持稳健,不同于移动平均线工具;好的实现还会给出带有信心和市场状态背景的细腻概率读数。相比常见的移动平均线工具箱,它确实提供了一个真正不同的市场视角。
但它不是魔法,诚实面对限制,正是优秀用户和失望用户的分水岭。它仍然是在历史数据上做模式匹配:如果未来不再像过去,例如出现没有历史类比的真正市场状态变化,它的邻居就会变得误导。它不知道任何事情为什么发生,只知道相似读数之后通常发生了什么。它可能因为过度调参而曲线拟合,这也是为什么诚实回测很重要;并且像任何指标一样,它也会出现连续亏损。它是一个高质量的概率信号,应与结构、背景和严格风险管理结合,而不是单独使用的神谕。
应该单独交易 Lorentzian 信号吗?
使用 Lorentzian Classification 的有效方式,是把它当作高质量方向过滤器和背景引擎,而不是盲目的买入/卖出触发器。让分类器告诉您当前哪一边具有历史优势、它有多大信心,然后在行动前要求您自己的确认:同方向的市场结构转变(MSS)、关键价位,或单独的入场信号。分类设定倾向;您的结构和风险计划决定交易。
把分类器变成过滤后的信号
用信心和市场状态过滤原始分类,然后要求您自己的确认。
它也天然适合任何指标都需要的同一套纪律:更重视高信心信号,尊重仪表板提供的市场状态和波动率背景,并用严格的风险管理给每笔交易设定仓位规模,确保单次误分类不会造成伤害。由于 Quantum ML Engine 明确展示信心、市场状态和波动率,您可以建立简单规则,例如只在趋势市场状态中交易高于某个信心阈值的信号,把原始分类器变成一套有纪律的过滤系统。
• Adaptive Lorentzian engine — 自适应 K、市场状态和波动率检测,并带有信心评分
• 诚实校准 — 透明的校准读数,明确不作为回测呈现
• 可问责表现 — 每个信号背后都有已验证的公开实盘记录
◆ 试用 Adaptive Lorentzian engine
Quantum Algo 的 Adaptive Lorentzian Classification,也就是上方展示的 Quantum ML Engine,会把自适应 K、市场状态与波动率检测、信心评分和诚实校准带到您的图表上,并叠加与套件其他部分相同的聪明钱概念(SMC)背景,所有内容都有已验证的公开实盘记录支持。
在 TradingView 上查看脚本 → 验证实盘记录常见问题
Lorentzian Classification 是一种机器学习指标,会把交易视为模式识别问题。它使用 k 近邻模型,寻找与当前条件最相似的历史 K线,并根据那些相似过去情境之后的走势,对下一步可能走势进行分类。它的定义性特征是使用 Lorentzian 距离,而不是普通 Euclidean 距离来衡量相似性,这让它在波动市场中更稳健。
每根历史 K线都被存储为特征空间中的一个点,坐标轴是 RSI、Wave Trend 振荡指标和 ADX 等指标读数。当新 K线形成时,模型会测量它到每根已存储 K线的 Lorentzian 距离,保留 k 个最近的“最近邻”,并观察每个邻居之后价格如何演化。如果大多数相似历史 K线随后上涨,当前 K线就被分类为看涨;如果大多随后下跌,就被分类为看跌。信号就是这些历史类比的聚合投票。
Lorentzian 距离是一种衡量两个市场快照差异的方法,借自时空数学。Euclidean 距离会把差异平方,因此单个大差距会主导结果;Lorentzian 距离不同,它只会随大差异按对数增长。这意味着单个极端、波动剧烈的读数不会放大到支配相似性度量,因此相似但波动的 K线会保持接近,模型即使在动荡市场中也能找到真正可比的历史情境,而这正是可靠类比最重要的时候。
是的,严格来说是成立的,k 近邻是最古老、最成熟的机器学习算法之一。它属于“机器学习”,因为它会通过带标签的历史样本来给新数据分类,而不是遵循手写规则。不过,它不是神经网络,也不是能“理解”市场的大模型;它是基于相似性的分类器。这个区别很重要:它强大且自适应,但它是在历史上做模式匹配,而不是推理原因。
K 是模型用于投票分类的最近邻数量。较小的 K 会让指标反应更快但噪音更大;较大的 K 会平滑投票但可能模糊真实信号。“Adaptive K” 意味着实现会根据市场条件调整这个数字,而不是固定它。例如,Quantum ML Engine 显示 Adaptive K 为 6/8,意思是在检测到的市场状态和波动率下,它当前在最多八个邻居中使用六个。
它通常会用一小组标准化技术读数描述每根 K线,常见的是 RSI 这类动量振荡指标、Wave Trend 或 CCI 风格的度量,以及 ADX 这类趋势强度度量。这些读数会变成 K线在特征空间中的坐标,相似性就在这个空间中被衡量。好的实现会让特征集保持紧凑、标准化且互补,因为特征太少无法区分情境,特征太多则会触发“维度灾难”,让每根 K线看起来都等距。
如果一个版本构建得当,并且只在已收盘 K线上分类,它就不会重绘;一旦 K线收盘,它的特征和分类就固定了。不过,实现各不相同,有些会在正在形成的 K线上显示实时更新,并在收盘时稳定下来。如果您依赖这些信号,请通过实时观察具体脚本的形成过程,并确认重新加载后历史分类不会移动,来验证它。和任何指标一样,只信任能经受已收盘 K线和实时测试的东西。
校准胜率是模型在短窗口中报告的近期命中率,用作当前校准状况的健康检查。重要的是,Quantum ML Engine 明确把它标注为“校准,不是回测”,这是一个诚实提醒:小规模近期样本上的命中率,只是衡量模型当前调校是否良好的指标,并不是对未来表现的预测。它应与信号、信心、市场状态和波动率一起作为概率背景阅读,绝不能当作保证。
它是在过去数据上做模式匹配,所以如果未来不再像过去,例如出现没有历史类比的真正市场状态变化,它的最近邻就会变得误导,优势也会减弱。它不知道任何事情为什么发生,只知道相似读数之后通常发生了什么。它可能因过度调参而曲线拟合,并且像任何指标一样会出现连续亏损。最好把它视为一个高质量的概率信号,并与市场结构、背景和严格风险管理结合,而不是单独使用的神谕。
把它当作方向过滤器和背景引擎,而不是盲目触发器。让分类器告诉您哪一边具有历史优势、它有多大信心,然后在行动前要求您自己的确认,例如同方向的市场结构转变、关键价位或单独的入场信号。由于 Quantum ML Engine 这类实现会明确展示信心、市场状态和波动率,您可以建立简单规则,例如只在趋势市场状态中交易高于某个信心阈值的信号,从而把原始分类器变成一套有纪律的系统。
它是不同,而不是严格意义上更好。移动平均线简单、透明,并且天生滞后;Lorentzian Classification 自适应、对波动稳健,并提供带信心和市场状态的概率背景,但它更复杂,也依赖历史是否像当前。许多交易者会发现它们互补:移动平均线或通道工具用于清晰趋势背景,Lorentzian 分类器用于更细腻的方向读数。两者都不能取代结构和风险管理。
Quantum Algo 在 TradingView 上发布了 Adaptive Lorentzian Classification,也就是本指南中展示的 Quantum ML Engine。它在核心 Lorentzian k-NN 方法之上加入自适应 K、市场状态和波动率检测、信心评分以及诚实校准,并叠加与套件其他部分相同的聪明钱概念(SMC)背景。您可以直接在 TradingView 上查看脚本,它的信号由 Quantum Algo 已验证的公开实盘记录支持。
参考资料与相关指南
本主题更多内容
- 机器学习交易指标(Lorentzian):完整指南
- SuperTrend AI(聚类):完整指南
- AI 交易日志:如何用它真正改进
- Gaussian Channel 指标指南
- 最佳 TradingView 指标
- 非重绘指标:可靠信号完整指南
- RSI 指标指南
- Squeeze Momentum 指标(TTM Squeeze):完整指南
- 最佳买入/卖出指标:如何选择真正有效的指标
- 交易策略回测:完整验证指南
- 聪明钱概念(SMC):终极交易指南
- 趋势交易策略:完整指南
- 最佳交易机器人排名:自动化您的交易
- Supertrend 指标指南