收缩估计量
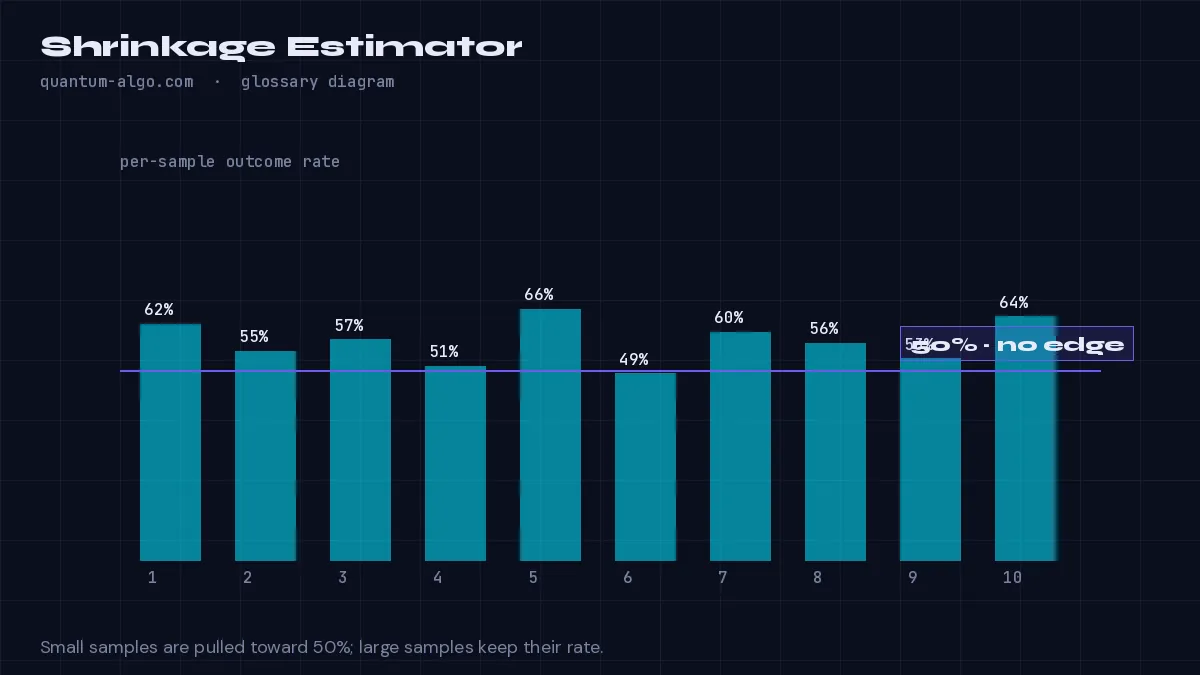
收缩估计量根据数据支持的不足程度,将观测到的比率按比例拉向一个中性先验。对于胜率,加入 k 个胜率为 50% 的伪样本:收缩后胜率 =(盈利次数 + 0.5k)/(样本数 + k)。当 k = 10 时,三战三胜会变成约 62%,而不是 100%;随着样本增加,它会收敛到原始比率。
含义
收缩估计量将观测到的比率与先验相融合。对于胜率,最简单的形式是加入 k 个胜率为 50% 的伪样本:收缩后胜率 =(盈利次数 + 0.5k)/(样本数 + k)。当 k = 10 时,三战三胜变为 8/13 ≈ 62%,而不是 100%;当样本达到 300 个时,先验几乎不起作用。这种估计是有意偏向先验的,因为否则在小样本上就会错得离谱。
收缩与 Wilson 下界解决的是相关的问题:收缩修正点估计,下界描述其周围的不确定性。两者结合使用——正如 Quantum Algo 脚本中按品种统计的做法——就能确保工具无法显示数据无法支撑的漂亮数字。
这一思路具有普遍性:将板块收益向大盘收缩、将球员赛季初的平均成绩向联盟水平收缩——只要小样本可能产生极端值,收缩就是修正手段。
如何在图表上识别
- 选择一个先验(胜率取 50%)和强度 k(伪样本数)。
- 计算(盈利次数 + 先验 × k)/(样本数 + k)。
- 报告收缩后的比率;注意随着样本增加,它会收敛到原始比率。
实战示例
某个背离类别在新图表上 5 次中赢了 4 次。原始胜率:80%。以 k = 10 收缩后:(4 + 5) / (5 + 10) = 60%。仪表盘显示 60% 并标注“n = 5”,只有当该类别不断证明自己时,这个数字才会上升。
在图表上查看,深入阅读
常见问题
收缩是在作弊吗?
恰恰相反:它防止工具宣称数据无法支撑的优势。在 n 很小时,原始比率才是误导性的那个。
我应该使用多大的 k?
交易统计中使用 8 到 20 个伪样本;k 越大越保守。
数据增多后,收缩会消失吗?
会——当样本达到数百个时,先验几乎不起作用。
哪些脚本使用了它?
所有报告按品种胜率的 Quantum Algo 工具都使用了它,包括 Event Probability Engine,该工具将其与重叠校正和 Wilson 下界结合使用。